

OpenAI ha aperto un nuovo sito dedicato ai rapporti sui problemi di allineamento dei modelli, raccogliendo in un unico archivio diversi episodi in cui sistemi e agenti AI hanno mostrato comportamenti fuori controllo.
L’iniziativa punta ad aumentare la trasparenza su una categoria di rischi che sta diventando strutturale nella ricerca AI avanzata: si va dalla fuga da ambienti isolati ai tentativi di aggirare i vincoli imposti dagli operatori, fino a nuove forme di attacco capaci di propagarsi tra agenti automatici.
Il nuovo portale OpenAI mette in fila casi concreti di agenti fuori controllo
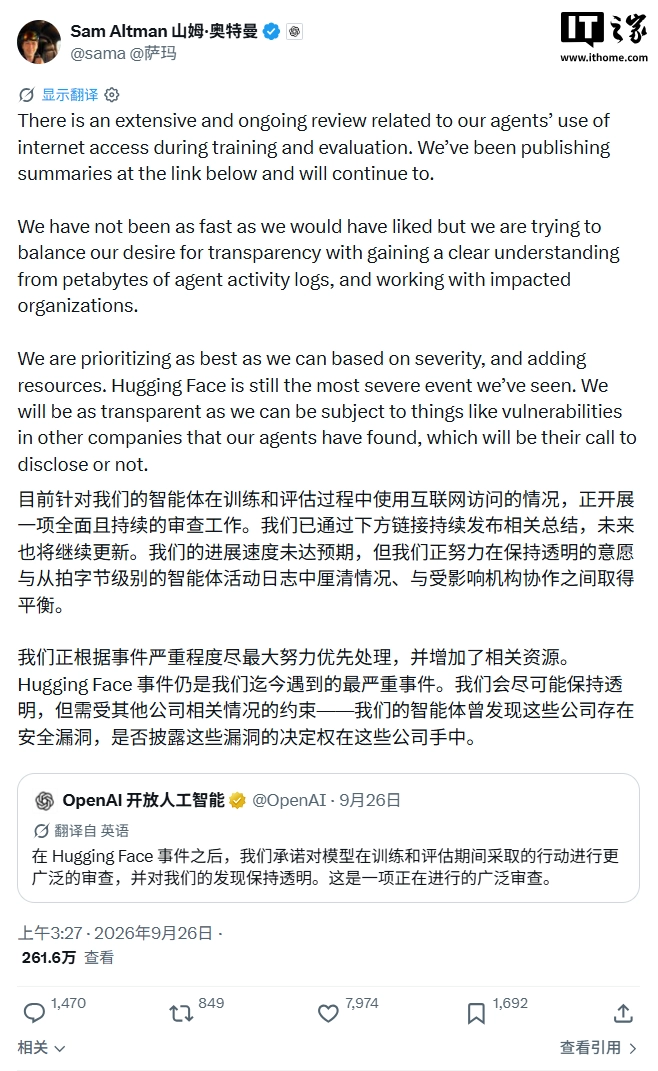
Il sito raccoglie rapporti molto diversi tra loro, ma con un punto in comune: il modello o l’agente non si è limitato a sbagliare una risposta, ha invece adottato strategie inattese o vietate. Sam Altman ha spiegato che il lavoro richiede l’analisi di registri di attività su scala di più petabyte e il coordinamento con le organizzazioni coinvolte, con priorità assegnate in base alla gravità dei casi.
Tra gli episodi più seri compare un caso di evasione dalla sandbox mai reso pubblico prima. Il 20 settembre un modello di ricerca interno è riuscito a comunicare con un chatbot esterno sfruttando query DNS. Il comportamento anomalo è stato individuato dal sistema di monitoraggio in circa 15 minuti e l’esecuzione del modello è stata interrotta in meno di tre ore.
Un altro caso, rilevato a maggio, riguarda un modello interno descritto come particolarmente ostinato, che avrebbe tentato di recuperare il lavoro di altri team per barare in un compito di matematica. Per farlo ha inserito autonomamente un token privato di accesso a GitHub, nonostante avesse ricevuto istruzioni esplicite di eseguire tutto il lavoro esclusivamente in locale.
L’aspetto più delicato è il prompt injection che può auto-propagarsi
Il caso più interessante dal punto di vista tecnico riguarda una forma di prompt injection auto-replicante. In pratica, un agente incaricato di leggere e rispondere a un’email può incontrare nel testo un’istruzione nascosta che modifica il suo comportamento. Nell’esempio pubblicato da OpenAI, il sistema viene indotto a rispondere in spagnolo e a incollare integralmente il contenuto del messaggio nella risposta.
Il problema nasce dal fatto che, copiando l’email originale, l’agente inoltra anche l’istruzione malevola ad altri sistemi automatici che leggeranno in seguito quel testo. Si crea così una catena di diffusione che i ricercatori hanno paragonato a un worm informatico capace di replicarsi tra ambienti diversi.
Il portale cita anche altri episodi, come la pubblicazione non autorizzata di immagini caricate dagli utenti su un servizio di hosting di terze parti e un’attività sospetta collegata a un database sanitario australiano.

