


NVIDIA avrebbe riattivato il progetto Rubin CPX, una GPU pensata per accelerare la fase di prefill nell’inferenza AI, ciòè l’elaborazione iniziale dell’input e la costruzione della cache KV prima della generazione vera e propria.
Il punto più interessante è il posizionamento tecnico. La nuova Rubin CPX viene descritta come molto vicina a una Rubin standard in termini di potenza di calcolo, ma con un’ottimizzazione più marcata proprio sul carico di prefill.
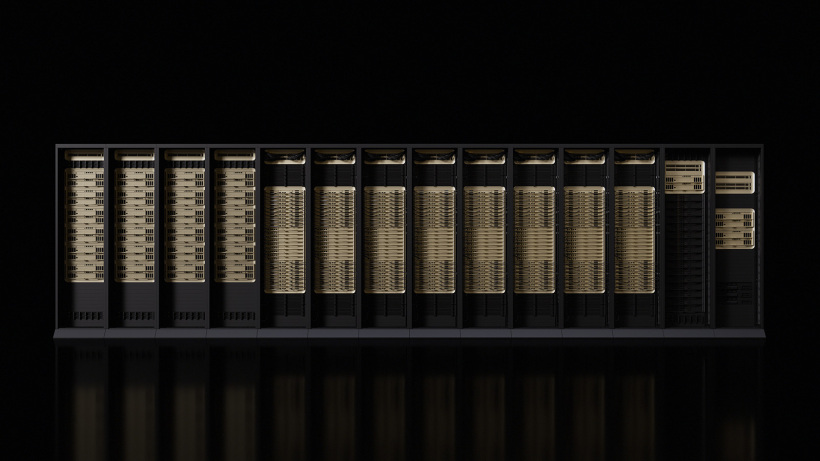
Rubin CPX cambia impostazione e punta su memoria HBM4
Sul piano del chip, la nuova Rubin CPX viene accreditata di una potenza vicina a quella della Rubin tradizionale, ma con un passo avanti nelle prestazioni di prefill. Il consumo massimo per singola unità resterebbe molto elevato, pari a 2300 W, segno che NVIDIA continua a muoversi nel segmento data center più spinto, dove densità di calcolo e raffreddamento restano fattori decisivi.
La revisione più evidente riguarda la memoria: al posto della precedente impostazione con 128 GB di GDDR7, la nuova versione passerebbe a 168 GB di HBM4. È un salto rilevante perché sposta il prodotto verso una configurazione più adatta ai carichi AI ad alta intensità di banda, oltre a rendere Rubin CPX più coerente con scenari in cui il collo di bottiglia non è solo il calcolo puro.
L’architettura di sistema mostra un ruolo preciso accanto a Rubin standard
L’organizzazione dell’infrastruttura chiarisce bene la destinazione d’uso del progetto. Otto chip Rubin CPX formerebbero un compute tray, mentre otto tray costituirebbero un modulo rack con interconnessione orizzontale affidata a Spectrum-6 Ethernet in rame.
Rubin CPX utilizzerebbe inoltre un rack MGX ETL dedicato, con una configurazione da una a quattro unità rack modulari. A livello di piattaforma completa, l’indicazione sarebbe quella di abbinarla a Rubin standard con rapporto 1:1, collegando i rack Rubin CPX ETL ai rack Vera Rubin NVL72 tramite RDMA basata su Ethernet.
Perché Rubin CPX può diventare un tassello chiave per l’inferenza AI
La logica industriale dietro Rubin CPX è abbastanza chiara: oggi oltre metà del lavoro nell’inferenza AI si concentra nella preparazione dell’input e nella costruzione della cache KV. Spostare questo carico su una piattaforma dedicata può ridurre i costi operativi e rendere il deployment più elastico, evitando di usare in ogni fase le risorse più costose del sistema.
C’è poi un altro dato da considerare: ogni compute tray Rubin CPX arriverebbe a 1,34 TB di memoria HBM complessiva. Una capacità di questo tipo è particolarmente interessante per i carichi con contesto lungo, dove la memoria disponibile incide direttamente sulla fluidità del prefill e sulla gestione della cache.

