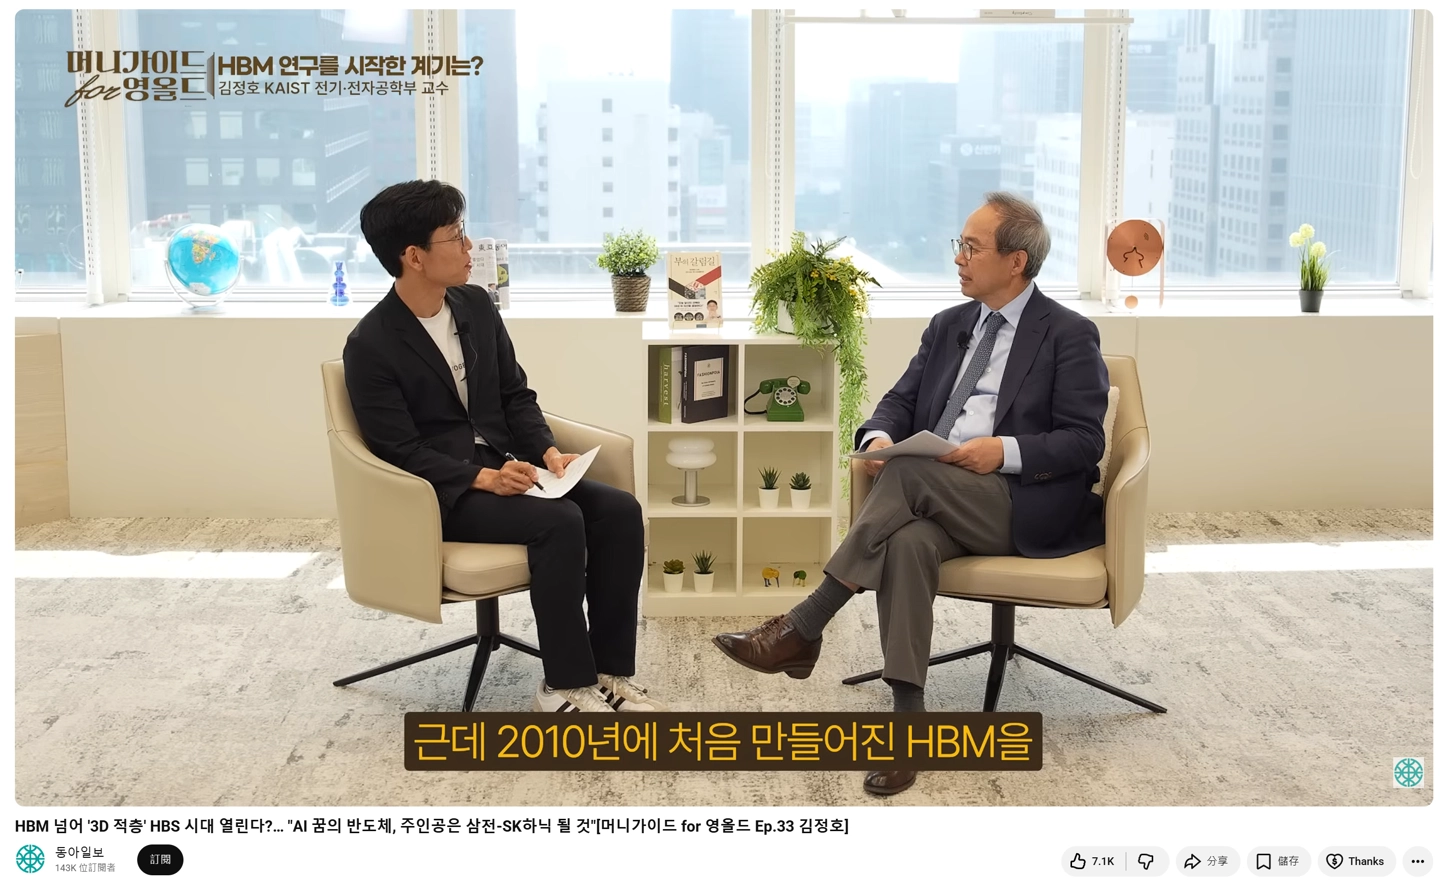
Kim Jeong-ho, docente del KAIST noto come il “padre dell’HBM”, sostiene che nella fase attuale dell’AI il collo di bottiglia non sia più soltanto la GPU. Il punto centrale, sempre più, è la memoria: capacità, larghezza di banda e velocità con cui i dati vengono spostati e resi disponibili al calcolo.
La tesi è netta: nell’inferenza AI le GPU lavorano davvero solo per il 10%-30% del tempo, mentre il resto si perde nel trasferimento dei dati tra memoria e processore. È un cambio di prospettiva importante, perché sposta l’attenzione dalle sole unità di calcolo all’intera architettura di memoria che alimenta i carichi AI.
Perché nell’inferenza AI la memoria sta diventando più importante della sola GPU
L’idea di Kim Jeong-ho parte da un dato semplice: ogni risposta generata da un sistema AI richiede prima la lettura dei dati dalla memoria HBM, poi l’elaborazione sulla GPU e infine la scrittura del risultato di nuovo in memoria. In questa catena, una parte molto ampia del tempo non viene spesa per il calcolo puro, ma per il trasporto dei dati.
Per questo, anche aumentando drasticamente il numero di acceleratori installati, l’efficienza reale non cresce in modo lineare. Se la GPU resta in attesa dei dati, la potenza teorica disponibile non si traduce automaticamente in prestazioni concrete. È qui che memoria, banda passante e capacità iniziano a contare quanto, se non più, della sola potenza di calcolo.
Kim distingue anche tra il passato recente dell’AI e la fase che si sta aprendo adesso. Nel periodo dominato dall’addestramento, la GPU era il fulcro del sistema; nell’era dell’inferenza AI, invece, il fattore decisivo diventa quanta informazione si può gestire e con quale rapidità la si può fornire al motore di calcolo.
- Utilizzo reale della GPU nell’inferenza: 10%-30%.
- Il tempo restante viene assorbito soprattutto da lettura, trasferimento e scrittura dei dati.
- La prestazione AI dipende sempre più da banda e capacità della memoria, non solo dal numero di GPU.
Da HBM a HBF e HBS: come può cambiare la gerarchia della memoria per l’AI
L’HBM resta oggi la soluzione di memoria più strettamente associata ai chip AI, ma Kim ritiene che non sarà l’unica risposta nel medio termine. Con la crescita di modelli multimodali e di sistemi agentici, aumenterà il fabbisogno di archiviare grandi quantità di dati meno caldi, come video, documenti e memoria di lungo periodo.
Per questo entra in gioco il concetto di HBF, ciòè memoria flash NAND impilata con una logica simile a quella dell’HBM. L’obiettivo è offrire una riserva molto ampia di dati accessibili con maggiore efficienza rispetto alle soluzioni tradizionali, così da sostenere carichi AI che devono gestire informazioni eterogenee e persistenti.
La previsione è ambiziosa: entro dieci anni la domanda di HBF potrebbe superare quella di HBM. Guardando ancora più avanti, Kim immagina poi l’arrivo di HBS, una memoria ad alta banda basata su SRAM, con velocità di lettura e scrittura molto superiori alla DRAM e con un ruolo da cache ultraveloce nell’infrastruttura AI.
- HBF: memoria flash NAND impilata pensata per grandi volumi di dati “freddi”.
- HBS: soluzione futura basata su SRAM, indicata come molto più rapida della DRAM.
- Previsione di mercato: in 10 anni la domanda HBF potrebbe superare quella HBM.
L’architettura AI del futuro può diventare un sistema 3D a circa 100 strati
La parte più interessante della visione di Kim è la descrizione del computer AI del futuro come un grande edificio tridimensionale. In questa metafora, HBM, HBF e HBS avrebbero ruoli diversi ma complementari: memoria ad alta banda per il lavoro immediato, memoria ad alta capacità per i dati persistenti e cache ultraveloce per ridurre al minimo le attese.
Il risultato sarebbe una struttura composita a circa 100 strati, con più livelli di memoria impilati e coordinati per nutrire in modo continuo la GPU. È una prospettiva che va oltre il semplice aumento della potenza dei singoli chip e punta invece a migliorare l’intero flusso dei dati, che oggi rappresenta il vero limite prestazionale in molti scenari AI.
Per chi segue il settore dei semiconduttori, questo ragionamento è rilevante perché suggerisce dove si concentreranno i prossimi investimenti: non soltanto su acceleratori sempre più potenti, ma su packaging avanzato, memorie specializzate e integrazione 3D. In pratica, il vantaggio competitivo potrebbe spostarsi sempre più vicino alla memoria.
- Architettura prevista: struttura 3D con circa 100 strati.
- Obiettivo principale: ridurre i tempi morti dovuti al movimento dei dati.
- Aree chiave da monitorare: memoria specializzata, packaging 2.5D/3D e integrazione di sistema.