

Alibaba aggiorna HappyHorse alla versione 1.1, il suo modello per la generazione video, con miglioramenti mirati su movimento, coerenza del soggetto, comprensione dei prompt, resa visiva e capacità audio. L’obiettivo è rendere più credibile e controllabile la produzione di clip AI per contenuti pubblicitari, short video e storytelling visivo.
La novità è già disponibile su sito ufficiale di HappyHorse, Alibaba Cloud Bailian e Qianwen Cloud. Il modello mantiene le specifiche principali della versione precedente, con video da 3 a 15 secondi e supporto a 720p e 1080p, oltre al formato libero del rapporto tra i lati.
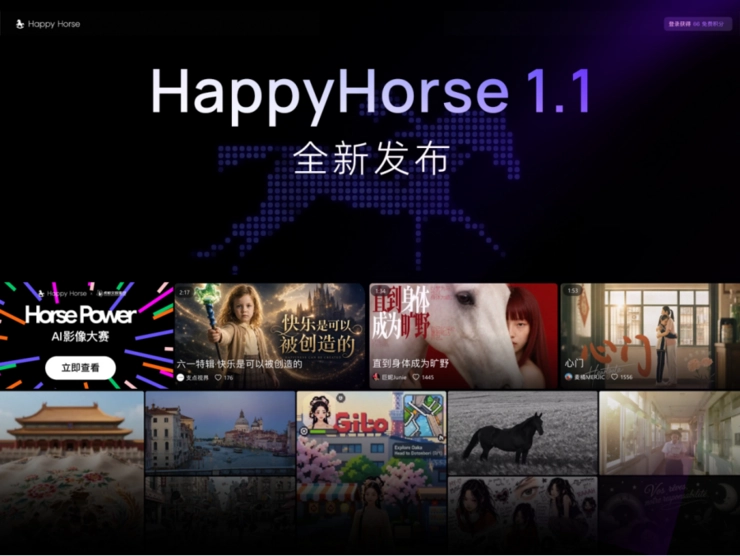
HappyHorse 1.1 punta su video più fluidi e coerenti
La revisione 1.1 introduce un salto soprattutto nella qualità del movimento: secondo quanto indicato, il modello migliora la modellazione del moto e la coerenza temporale, così da ridurre sequenze con azioni lente o poco incisive. Il risultato atteso è una resa più naturale di persone e oggetti in movimento, con una maggiore sensazione di dinamismo.
L’aggiornamento interviene anche sulla comprensione di istruzioni complesse e sulla pianificazione delle scene. Questo significa che HappyHorse 1.1 gestisce meglio prompt articolati, più personaggi e più ambienti, mantenendo una struttura narrativa più stabile durante la generazione.
- Migliorata la fluidità del movimento e la continuità temporale.
- Più forte la coerenza tra soggetto generato e materiali di riferimento.
- Rafforzata la comprensione di prompt complessi e scene multiple.
- Aggiornate anche la qualità visiva e la gestione dell’audio.
Migliorano anche riferimento visivo dettaglio e audio
Uno dei punti più interessanti è il rafforzamento della funzione di video da riferimenti multipli, indicata come R2V. In pratica, il modello riconosce e fonde meglio più immagini di partenza, con un’aderenza più precisa a prodotti, personaggi e ambientazioni. Questo è utile quando serve mantenere dettagli come elementi di brand, linee del prodotto o continuità tra più inquadrature.
Sul fronte della qualità d’immagine, HappyHorse 1.1 lavora meglio sui volti e sulla pelle, riducendo effetti troppo aggressivi come nitidezza eccessiva, aspetto oleoso o texture innaturali. Rimangono i dettagli realistici, come pori, rughe di espressione e piccole imperfezioni, ma con una resa più equilibrata.
Anche l’audio fa un passo avanti: il modello adatta meglio parlato, pause e tono emotivo al contesto, e interpreta con più precisione le descrizioni sonore inserite nel prompt. La sincronizzazione tra immagine e suono viene descritta come più accurata, riducendo gli sfasamenti tra azione e audio e rendendo il risultato finale più immersivo.
- Supporto più forte alla generazione da più immagini di riferimento.
- Maggiore precisione nel mantenere dettagli di prodotto e soggetto.
- Migliore resa di pelle, volti e dettagli del viso.
- Audio più coerente con scena, ritmo e tono emotivo.
- Sincronizzazione audio-video più precisa rispetto alla versione precedente.

