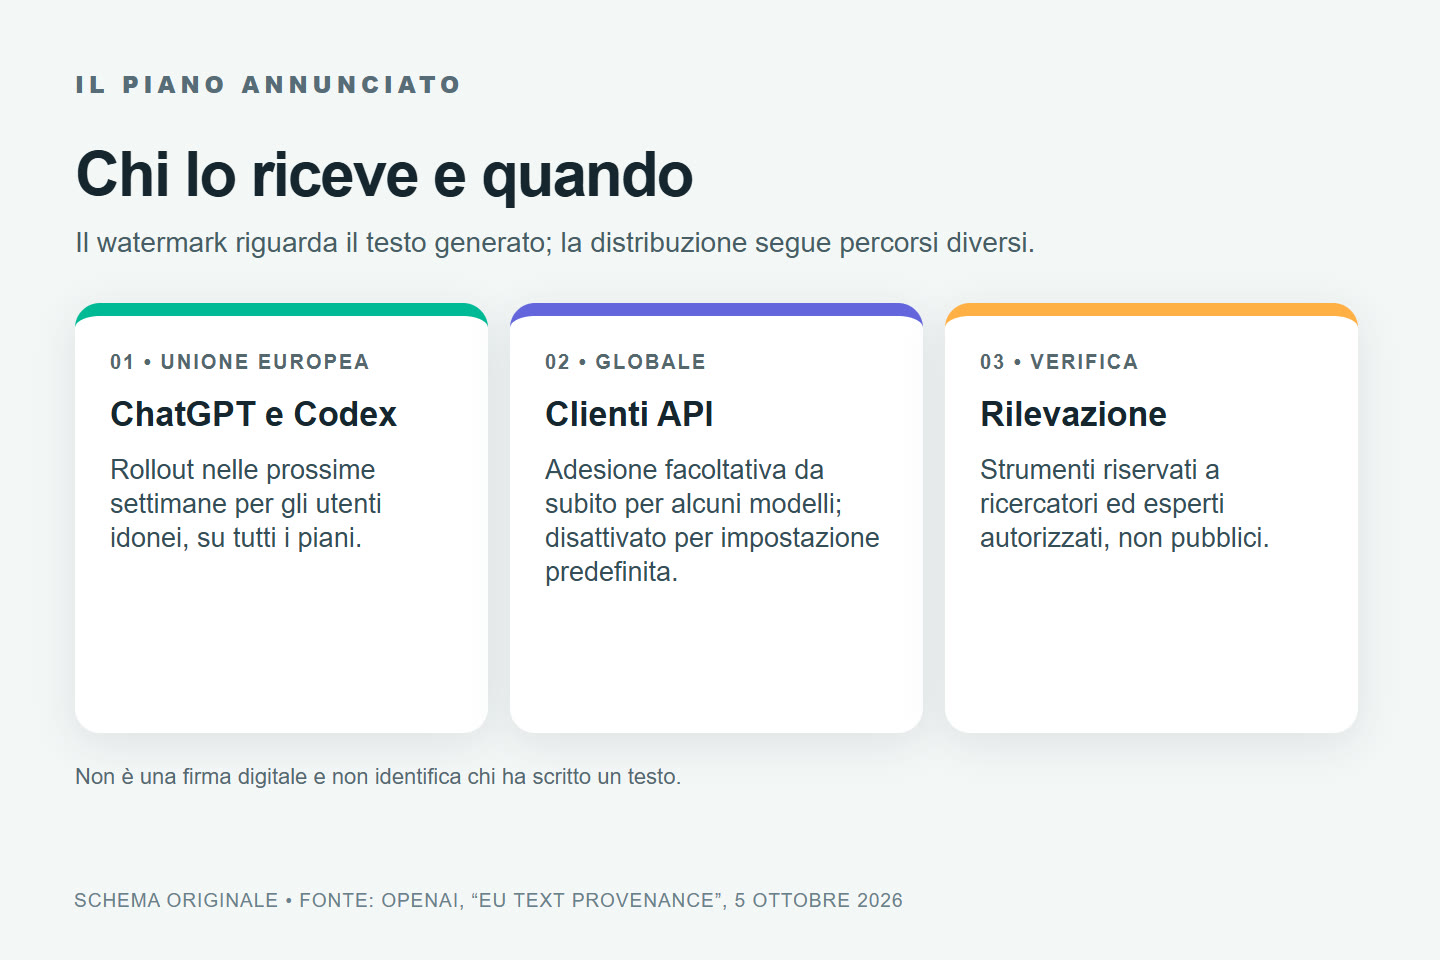
OpenAI introdurrà un watermark invisibile nel testo generato da ChatGPT e Codex nell’Unione europea. Il rilascio non è immediato per tutti: inizierà nelle prossime settimane, riguarderà gli output idonei su tutti i piani e, almeno al debutto, non sarà la configurazione predefinita a livello mondiale. È una misura per rendere più riconoscibile il contenuto prodotto dall’AI, ma non una prova certa della sua origine.
Il piano per ChatGPT, Codex e API
Il percorso annunciato oggi distingue due casi. Per gli utenti europei di ChatGPT e Codex, il watermark arriverà progressivamente nei testi che soddisfano i requisiti tecnici. I clienti delle API, invece, possono scegliere già da oggi di attivarlo a livello globale per alcuni modelli; nelle API resta disattivato per impostazione predefinita. OpenAI collega questa scelta graduale agli obblighi di trasparenza dell’AI Act europeo e ai limiti ancora presenti nella rilevazione automatica.
Come funziona textGrain
La tecnologia, chiamata textGrain, inserisce un segnale statistico nelle scelte delle parole del modello. Non aggiunge una scritta visibile o un’etichetta da leggere a schermo: serve a un rilevatore per stimare se un passaggio contiene il watermark di OpenAI. L’azienda ha aperto le candidature per accedere al rilevatore, ma in questa prima fase lo riserverà a ricercatori e organizzazioni esperte approvati. Non sarà quindi uno strumento pubblico per controllare qualunque testo.
Gli strumenti già disponibili per verificare alcune immagini e tracce audio generate dai sistemi OpenAI seguono un percorso diverso e continueranno a essere accessibili pubblicamente. La novità di oggi riguarda specificamente la provenienza del testo.
Quanto è affidabile il rilevamento?
I risultati comunicati da OpenAI mostrano una forte dipendenza dalla lunghezza e dal tipo di contenuto. Con un obiettivo di falsi positivi dell’1%, nei suoi test su testi di psicologia il rilevatore ha individuato il segnale in circa l’80% dei passaggi da 200 token e nel 95% di quelli da 400 token. I risultati sono inferiori in ambiti come la matematica, dove la scelta delle parole è meno flessibile.
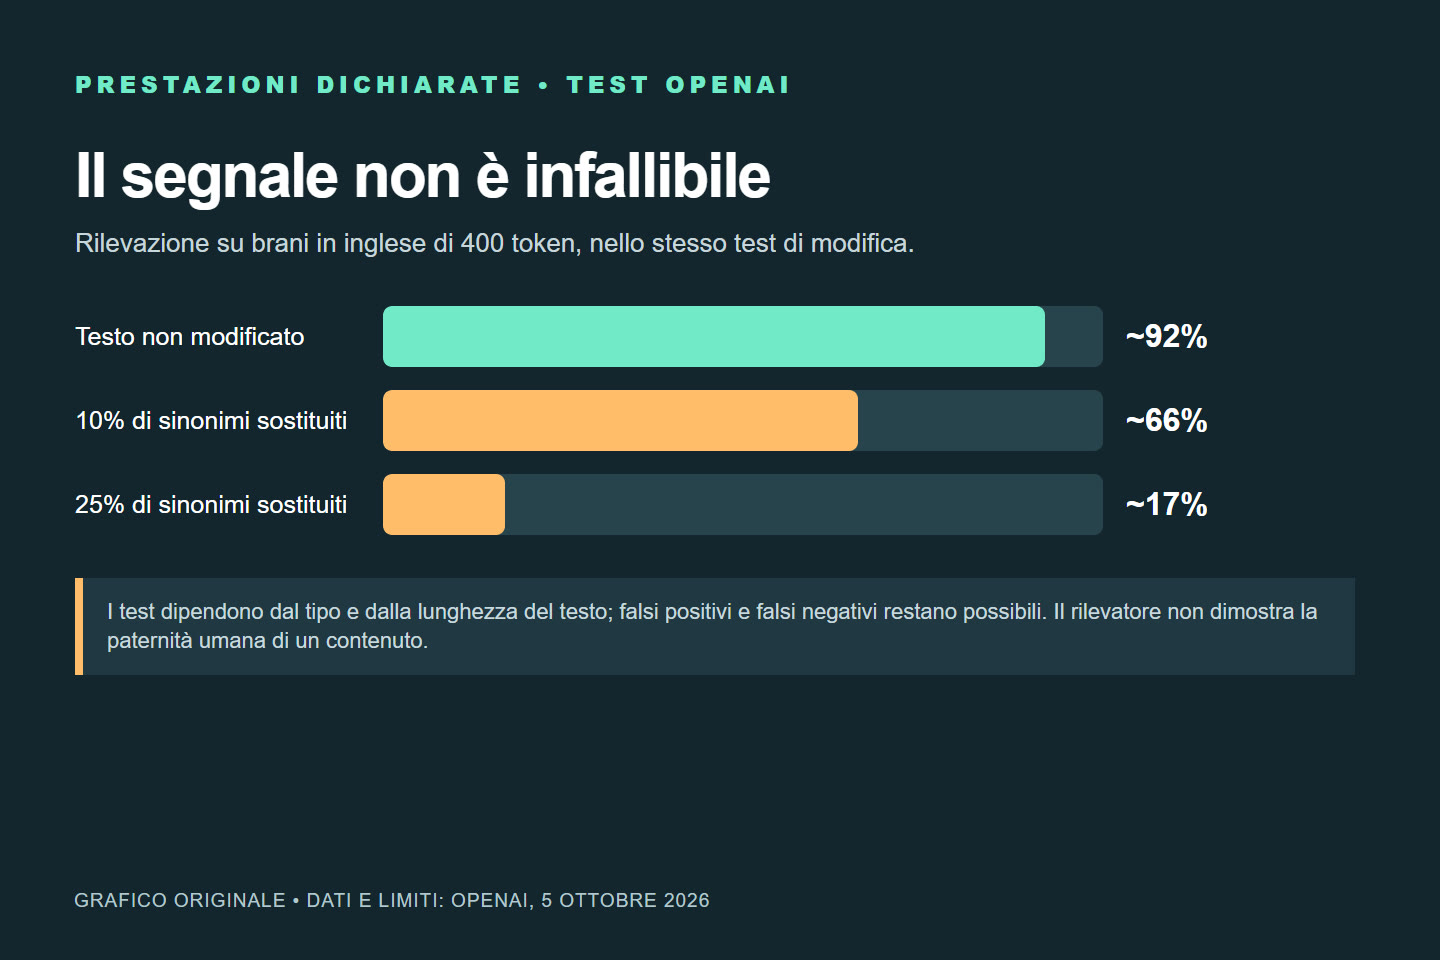
La modifica del testo indebolisce ulteriormente il segnale. In un test distinto su risposte in inglese da 400 token, la rilevazione passava da circa il 92% per il testo non modificato al 66% dopo la sostituzione del 10% delle parole con sinonimi; sostituendone il 25%, scendeva al 17%. Sono misure sperimentali, non una garanzia di riconoscimento di un singolo articolo o messaggio.
Cosa il watermark non dimostra
Un esito positivo può suggerire che un sistema OpenAI abbia generato o elaborato parte di un brano, ma non misura il contributo umano, non identifica l’utente e non stabilisce proprietà, responsabilità o accuratezza del contenuto. Anche un esito negativo non prova che il testo sia stato scritto da una persona: potrebbe essere breve, modificato o tradotto, provenire da un modello non supportato oppure precedere l’introduzione del watermark.
Il punto pratico è questo: il segnale aggiunge un indizio tecnico sulla provenienza del testo, non un verdetto automatico sulla sua autenticità. OpenAI dice che rivaluterà sia l’estensione del rollout sia l’accesso al rilevatore sulla base dei risultati e dei riscontri ottenuti.