


OpenAI ha presentato MedChemBench, un nuovo benchmark pensato per misurare quanto i modelli di intelligenza artificiale riescano a ragionare in attività legate alla chimica farmaceutica.
Il dato più interessante è che i modelli più avanzati mostrano già una buona tenuta nei compiti di ricostruzione strutturale e nella lettura delle evidenze scientifiche, ma restano ancora deboli quando devono scegliere il composto migliore o stimare valori numerici con precisione.
MedChemBench punta a valutare il ragionamento dei modelli nella ricerca farmaceutica
Il benchmark include 99 domande ricavate da 117 articoli scientifici e brevetti, con un totale di 761 strutture molecolari differenti. L’impostazione non si limita a domande teoriche: nella maggior parte dei casi il modello riceve il contesto di una ricerca in corso, con bersaglio biologico, obiettivo dei ricercatori, composti già studiati e parte dei risultati sperimentali disponibili fino a quel momento.
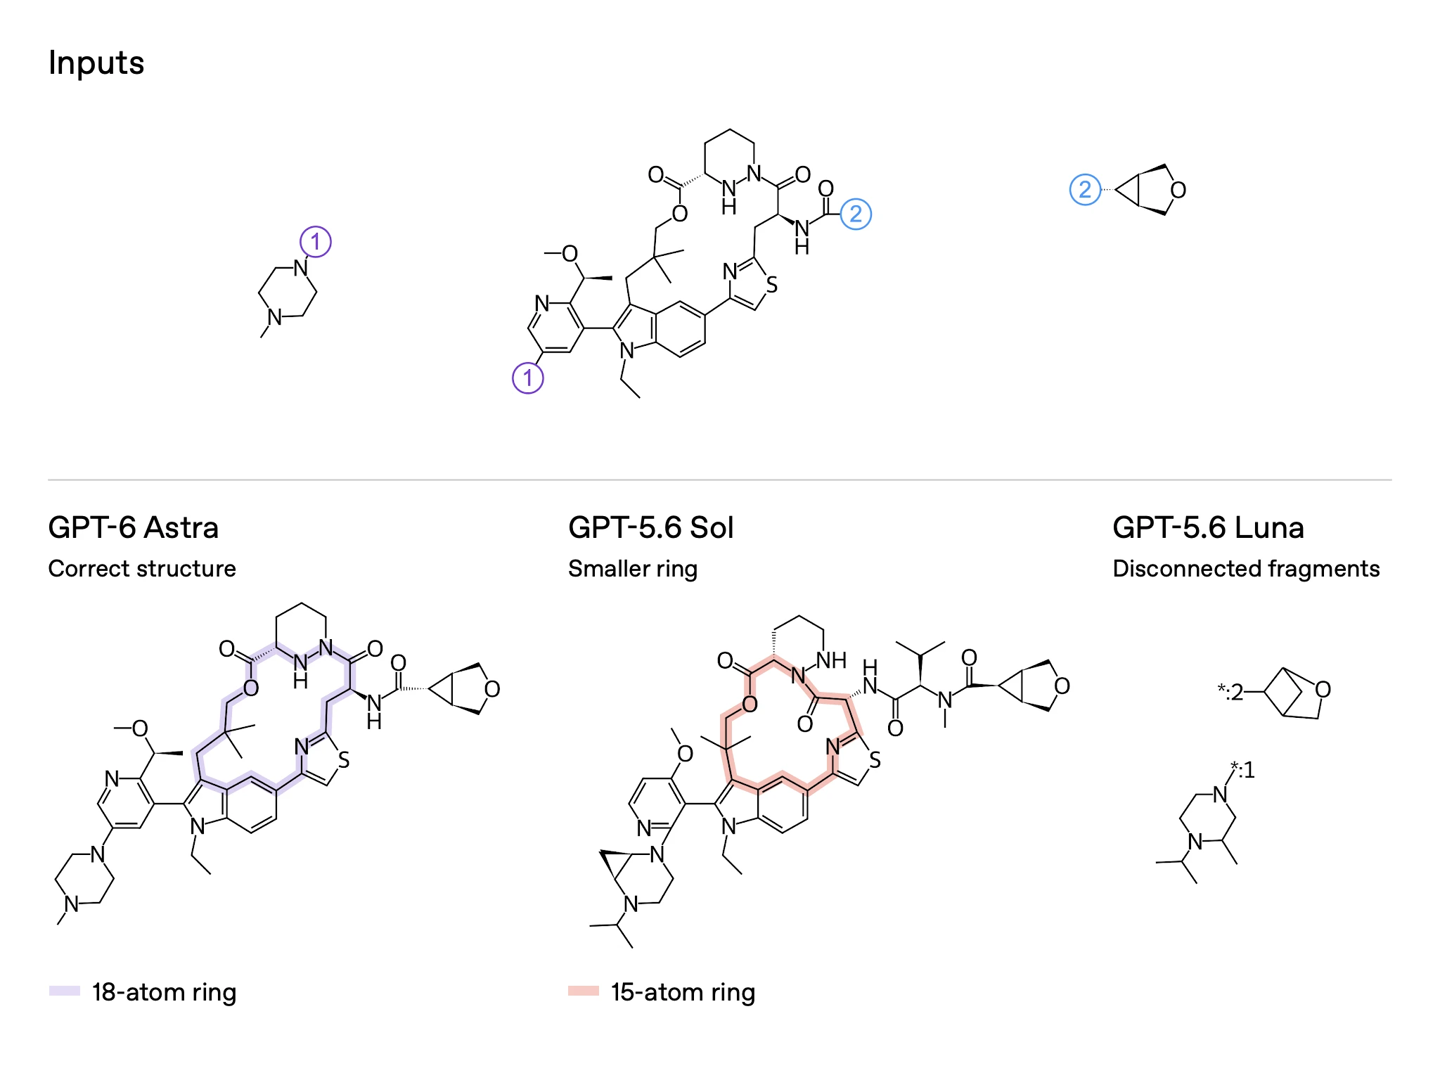
Le prove sono organizzate su più livelli. Una parte chiede di assemblare correttamente una molecola a partire da struttura di base e gruppi chimici, verificando sia la connettività degli atomi sia la stereochimica. Un’altra richiede spiegazioni scientifiche coerenti con le evidenze fornite, per esempio motivando la scelta di un composto rispetto ad altri.
GPT-6.2 Astra guida la classifica, ma selezione dei composti e stime numeriche restano i limiti principali
Nella modalità di ragionamento xhigh, GPT-6.2 Astra ha ottenuto un punteggio utile dell’84,5%, davanti a GPT-6 Astra con 83,3%, GPT-6.1 Sol con 82,0% e GPT-5.6 Sol fermo al 58,2%. OpenAI segnala che aumentare il livello di ragionamento porta benefici misurabili, ma il divario tra i modelli rimane evidente.
La differenza emerge soprattutto nei risultati per categoria. Astra raggiunge il 95,4% nella parte dedicata alle strutture molecolari, mentre scende attorno alla metà del punteggio nei compiti di selezione dei composti e di previsione numerica delle proprietà.
Gli esempi pratici mostrano progressi reali, ma non bastano ancora a dimostrare capacità di scoperta
Tra gli esempi mostrati c’è un esercizio in cui il modello deve costruire una molecola mantenendo un anello da 18 atomi partendo da un nucleo centrale e due sostituenti laterali. In questo scenario GPT-6 Astra ha risposto correttamente in tutte e dieci le prove eseguite nella stessa modalità, mentre modelli meno performanti hanno commesso errori strutturali evidenti.
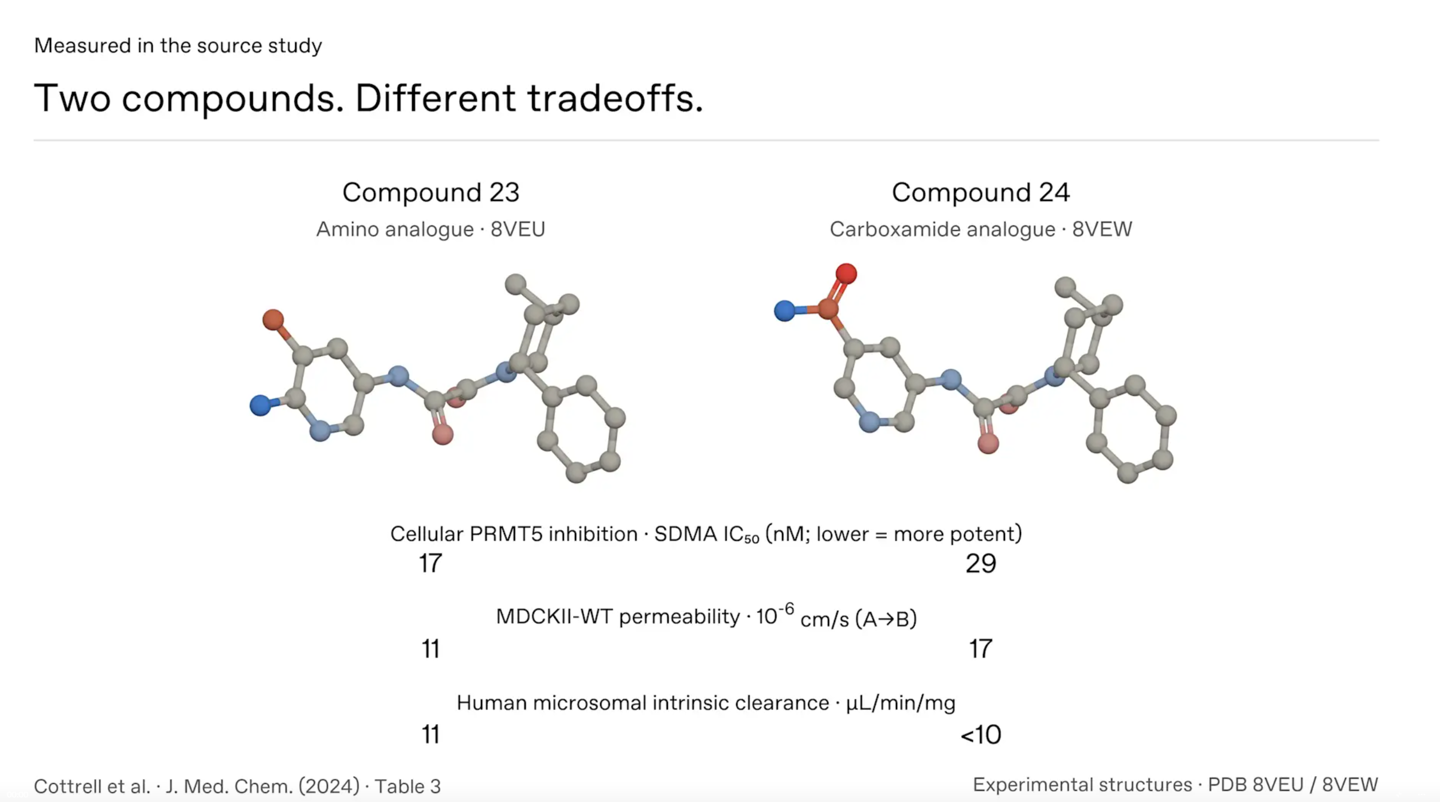
Un secondo caso riguarda inibitori di PRMT5, proteina osservata con attenzione nello sviluppo di farmaci antitumorali. Qui il modello deve stimare tre aspetti contemporaneamente: efficacia nel blocco cellulare del bersaglio, capacità di attraversare la barriera cellulare e velocità di degradazione da parte degli enzimi epatici in test di laboratorio.
OpenAI precisa comunque che questo benchmark non dimostra da solo la capacità di scoprire nuovi farmaci o di migliorare in modo diretto le decisioni di laboratorio. Le prove si basano su evidenze storiche già pubblicate e ogni risposta viene generata senza strumenti esterni, senza feedback e senza nuovi esperimenti.

