OpenAI ha pubblicato un nuovo report tecnico dedicato all’uso dei propri modelli AI nella progettazione dei chip, mostrando risultati concreti sia sul fronte interno sia nelle collaborazioni industriali.
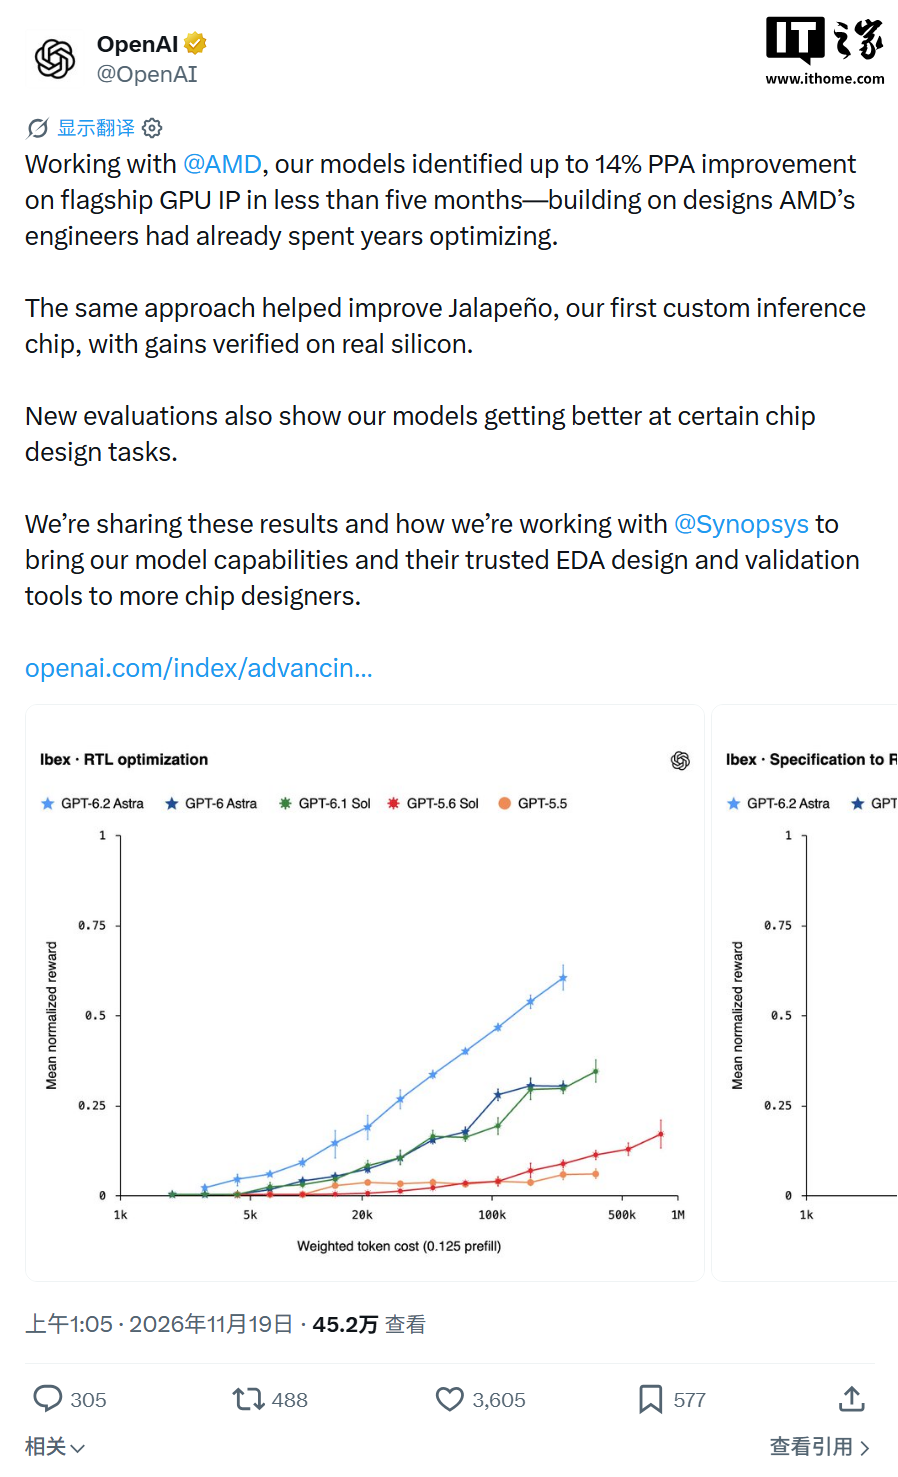
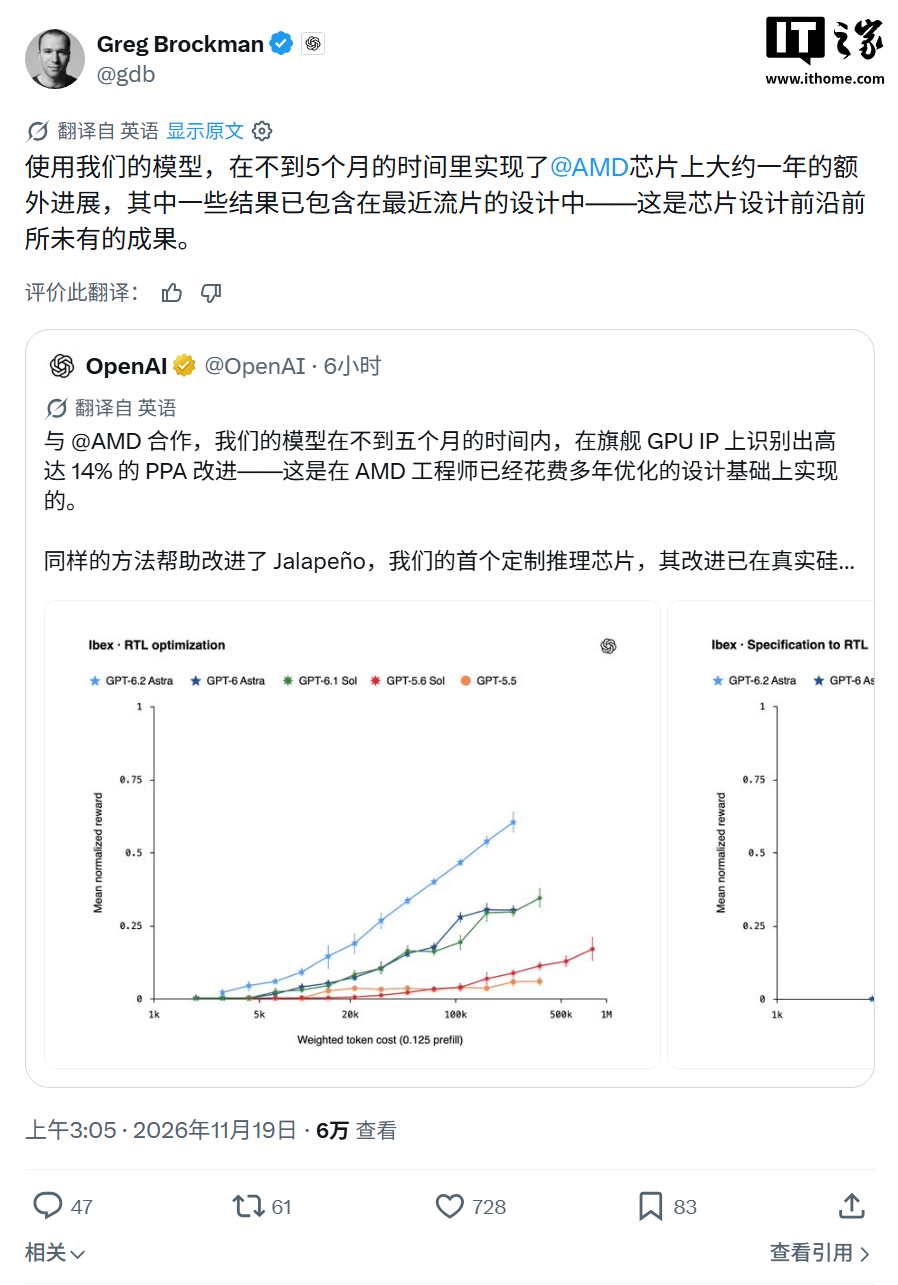
Tra i numeri comunicati spiccano una riduzione dell’area fino al 13% su alcune unità di Jalapeño e un miglioramento PPA fino al 14% su una GPU flagship AMD. PPA indica il bilanciamento tra prestazioni, consumi e area del chip, quindi è uno degli indicatori più importanti quando si valuta l’efficienza di un progetto destinato alla produzione.
OpenAI usa i suoi modelli per ottimizzare Jalapeño e ridurre area e latenza
OpenAI spiega che già all’inizio del 2025 i suoi ingegneri avevano iniziato a usare GPT-4o per supportare la progettazione del chip di inferenza Jalapeño. Il lavoro si è concentrato soprattutto sulle unità di calcolo vettoriale e matriciale, con interventi su addizionatori, moltiplicatori, logiche di riduzione, funzioni di conversione e unità speciali.
Nel dettaglio, alcune modifiche proposte dal modello hanno permesso di ridurre sensibilmente le risorse hardware necessarie. In un caso, il redesign di un moltiplicatore ha tagliato di circa il 15% l’area delle celle standard e ha portato la latenza da due cicli di clock a uno solo. Un altro intervento su un addizionatore ha ridotto l’area di circa il 15% mantenendo invariata la latenza.
Sui progetti AMD l’AI interviene anche sul codice RTL e accelera i tempi di sviluppo
La parte più rilevante per il settore riguarda però la collaborazione con AMD. OpenAI afferma che i propri modelli hanno contribuito all’ottimizzazione di GPU e CPU di prossima generazione, arrivando su una GPU di fascia flagship a un guadagno PPA massimo del 14% rispetto a una base già molto ottimizzata.
OpenAI sostiene che questo approccio equivale a comprimere circa un anno di lavoro di ottimizzazione in meno di cinque mesi. AMD ha già inserito parte delle modifiche in design recenti inviati alla produzione, mentre altre ottimizzazioni sono state aggiunte ai file di progetto per utilizzi successivi.
I test su core RISC-V e l’accordo con Synopsys indicano una strategia più ampia
Per misurare la capacità dei modelli in compiti più autonomi, OpenAI ha anche usato due core RISC-V open source a 32 bit, PicoRV32 e Ibex, chiedendo ai modelli di aumentare il throughput mantenendo la correttezza del progetto.
OpenAI chiarisce però che questi benchmark non replicano ancora tutti i vincoli di un chip commerciale completo, perché un modello può migliorare il punteggio anche eliminando funzioni secondarie poco utili al test.