

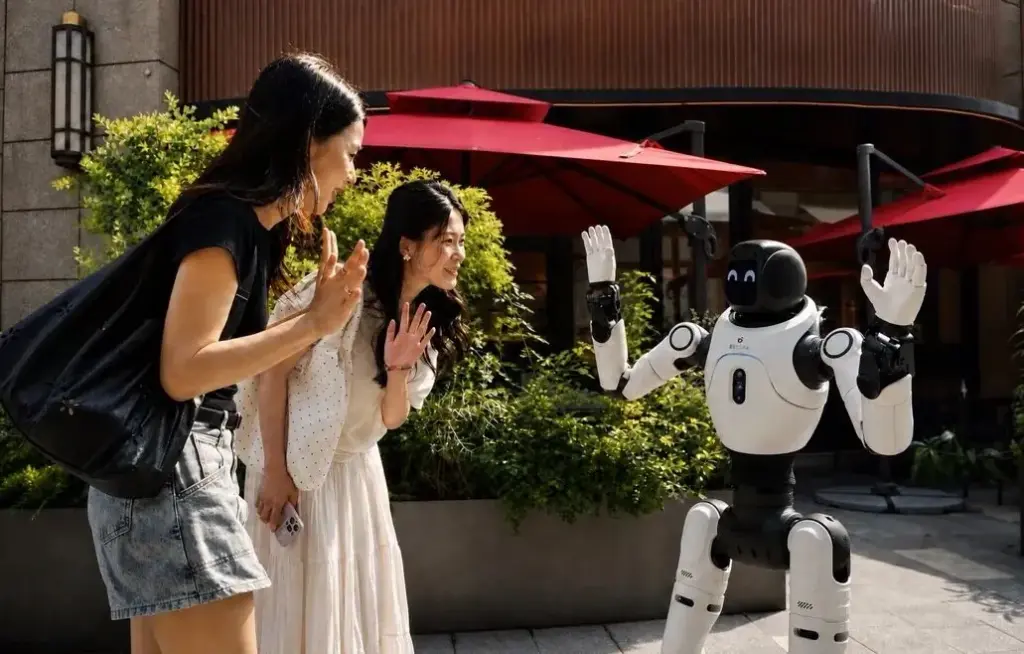
Agibot ha annunciato WITA-Omni, un modello pensato per far interagire i robot con le persone attraverso più segnali contemporaneamente. Oltre ad audio e video, riceve informazioni tattili e sullo stato del corpo; in uscita coordina voce, movimenti ed espressioni.
L’architettura streaming full-duplex è pensata per gestire più flussi contemporaneamente: il robot può continuare ad ascoltare mentre risponde e coordina i movimenti, riducendo l’attesa fra una fase e l’altra. Agibot dichiara risposte da circa 400 millisecondi nel caso migliore e circa 600 millisecondi in media.
Un altro obiettivo è capire quando una persona si sta rivolgendo al robot, senza richiedere una parola di attivazione. Il sistema combina voce, movimenti delle labbra, direzione, postura e contesto per decidere se rispondere.
Tra le capacità annunciate ci sono inoltre il supporto a oltre cento lingue e dialetti e la traduzione simultanea. Il display del volto può accompagnare le spiegazioni con contenuti visivi, mentre voce e movimenti vengono coordinati durante l’interazione.

