

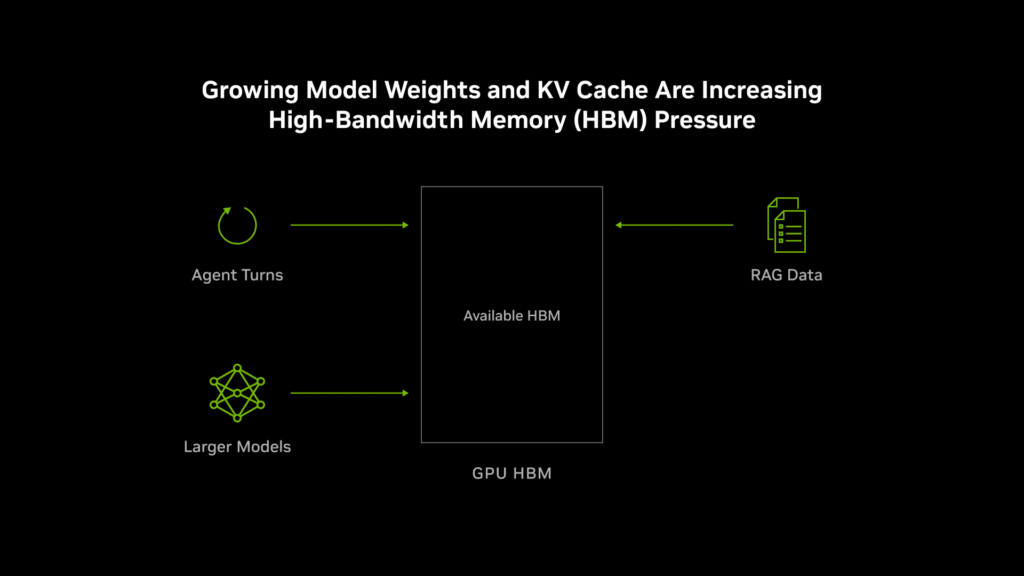
NVIDIA ha illustrato una strategia pensata per aggirare uno dei limiti più pesanti dell’AI moderna: la memoria video. L’idea è chiara: invece di inseguire solo un aumento della HBM, sempre più costosa e sotto pressione sul fronte della disponibilità, l’azienda punta a far lavorare insieme GPU, CPU, rete.
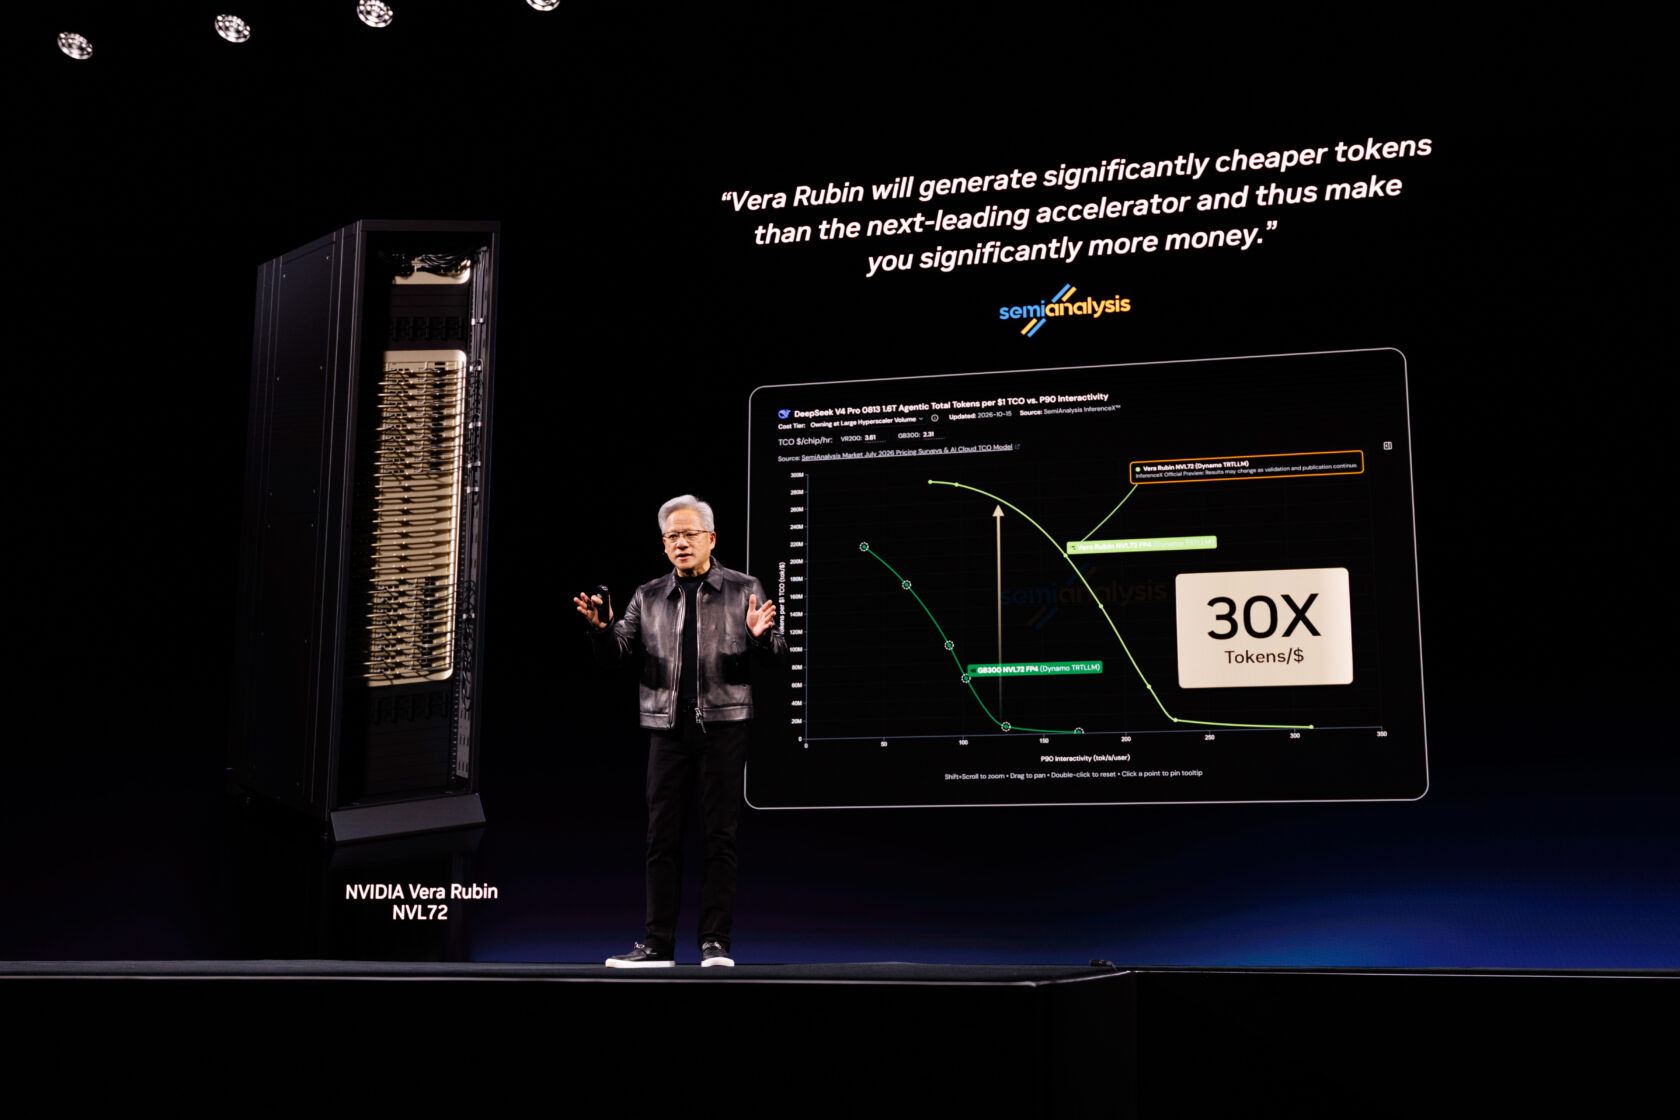
Il risultato dichiarato è rilevante soprattutto per i carichi legati agli agenti AI. In base ai dati condivisi da NVIDIA, con una crescita della capacità HBM di appena circa il 3%, il throughput per dollaro può arrivare fino a 30 volte rispetto alla generazione precedente in determinati scenari.
Perché la memoria è diventata il vero collo di bottiglia dell’AI
La pressione sulla memoria GPU cresce insieme a tre fattori: modelli con più parametri, contesti sempre più lunghi e diffusione degli agenti AI, che devono mantenere una cronologia estesa tra chiamate al modello e strumenti esterni.
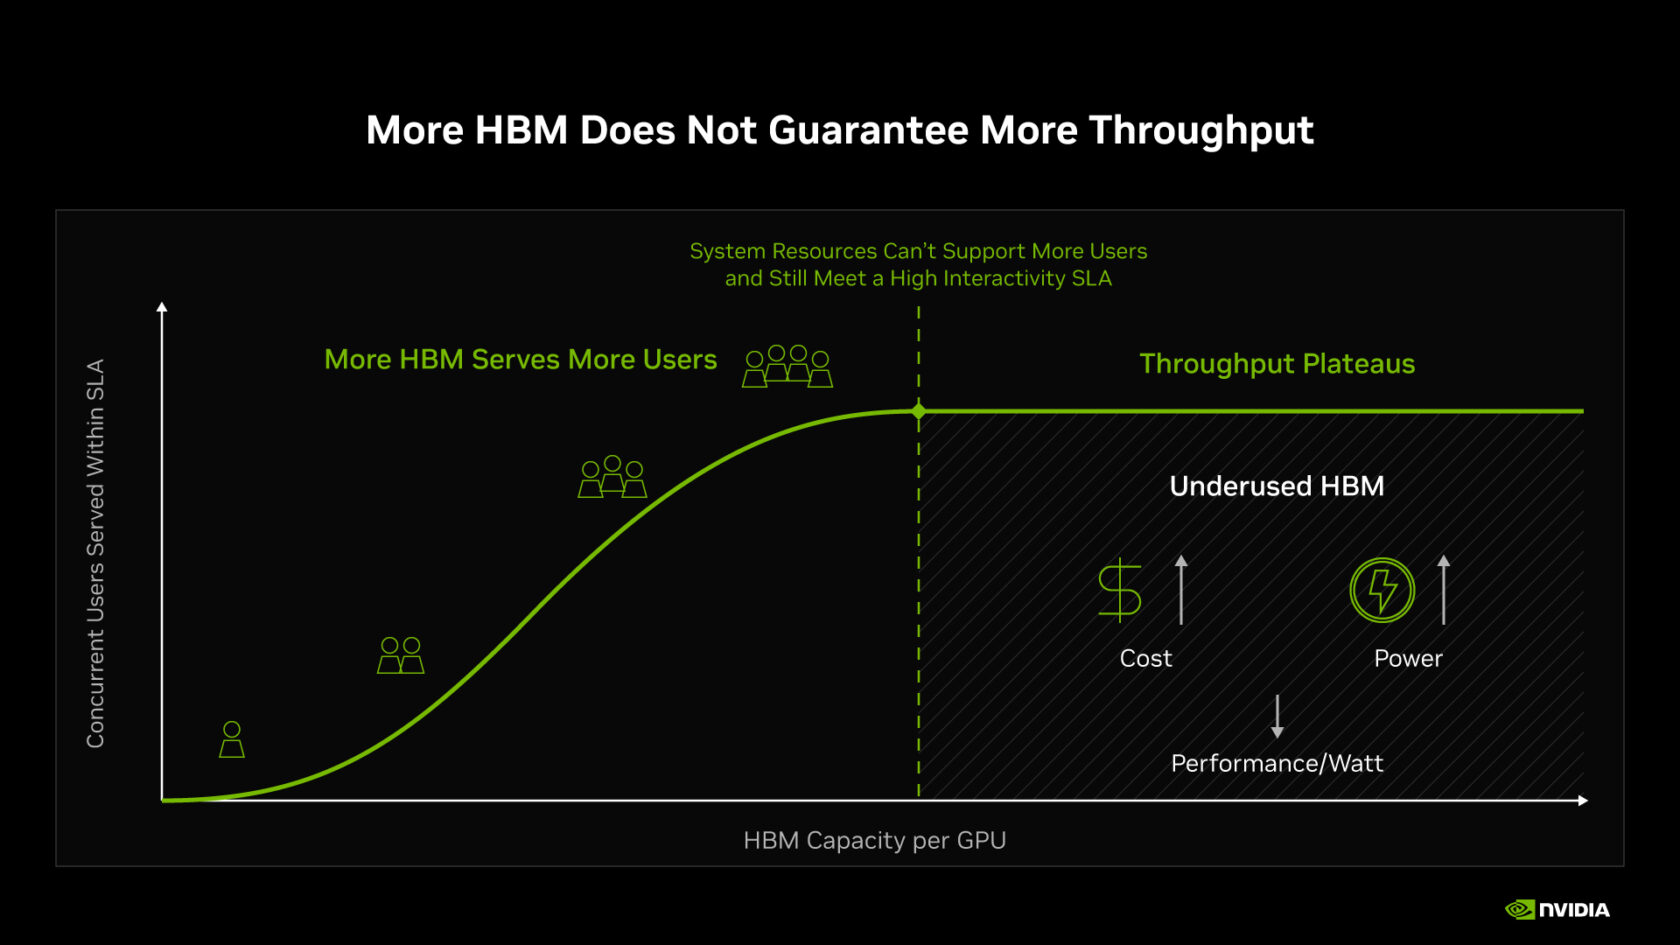
NVIDIA descrive la HBM come un magazzino e la larghezza di banda come il numero di punti di carico e scarico. Anche aumentando lo spazio disponibile, se i dati non si muovono abbastanza rapidamente si crea comunque un muro prestazionale. Per questo il punto non è solo avere più memoria, ma decidere dove comprimere i dati, dove conservarli e quando riportarli sulla GPU senza sprecare risorse costose.
Come funziona il design full-stack proposto da NVIDIA
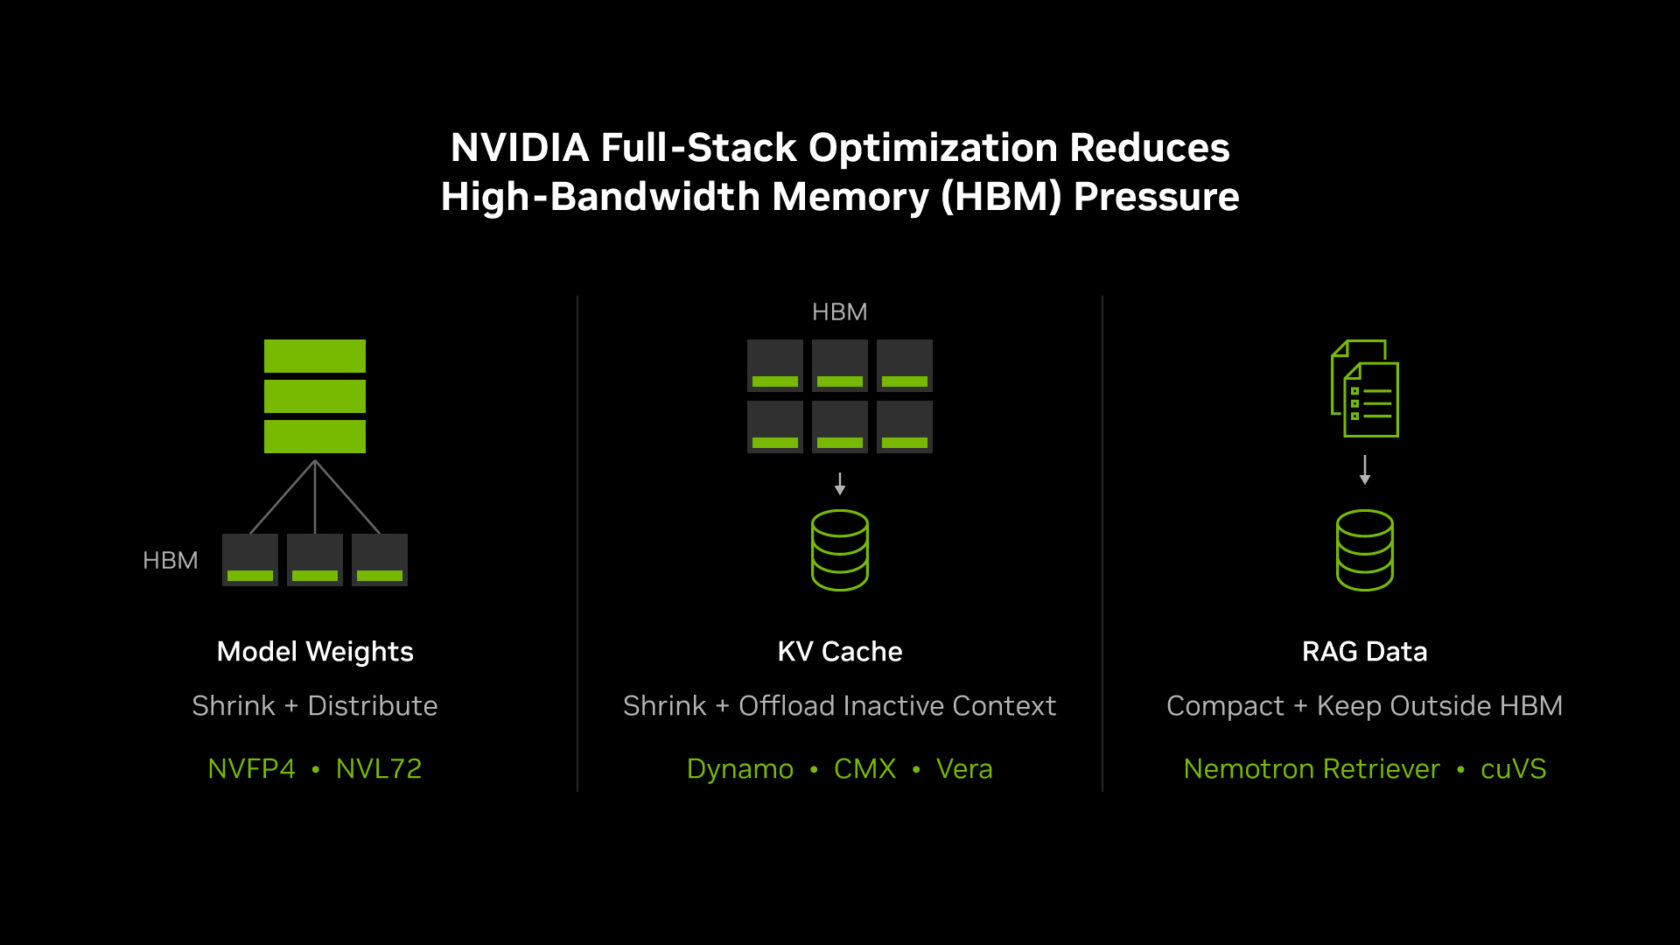
La soluzione passa da una progettazione coordinata dell’intera piattaforma. NVIDIA usa il formato a bassa precisione NVFP4 per comprimere pesi del modello e cache KV, due elementi che occupano una parte importante della memoria durante l’inferenza. Nel sistema NVL72 i pesi possono essere distribuiti su un massimo di 72 GPU, riducendo la pressione su ogni singolo acceleratore.
Un altro tassello è il ruolo della CPU. La piattaforma Vera sfrutta memoria LPDDR ad alta capacità come buffer vicino alla GPU per i contesti temporaneamente inattivi. Il software di inferenza Dynamo può invece spostare i contesti non attivi nello storage contestuale CMX e recuperarli quando servono di nuovo.
I numeri dichiarati mostrano un cambio di priorità nelle piattaforme AI
Nel benchmark AgentX di SemiAnalysis, con un carico di 125 token al secondo per utente, il sistema Vera Rubin NVL72 può arrivare a offrire un throughput per dollaro fino a 30 volte superiore rispetto a GB300 NVL72, pur con un incremento della HBM molto contenuto.
Il messaggio è molto concreto per chi osserva l’evoluzione dell’hardware AI: la competizione non si gioca più soltanto sulla quantità di memoria installata, ma su quanto valore si riesce a estrarre da ogni livello del sistema.

