

NVIDIA ha rilasciato CUDA Toolkit 13.5, aggiornamento che porta il supporto ufficiale a Vera Rubin e spinge l’ecosistema software verso una fase più matura per i carichi AI di addestramento e inferenza su larga scala.
L’update non si limita al supporto della nuova architettura: tocca librerie matematiche, strumenti di profiling, gestione delle risorse GPU e comunicazione multi-GPU. In pratica, NVIDIA punta a migliorare sia la parte di calcolo puro sia l’efficienza operativa dei sistemi accelerati, due aspetti centrali nei cluster AI moderni.
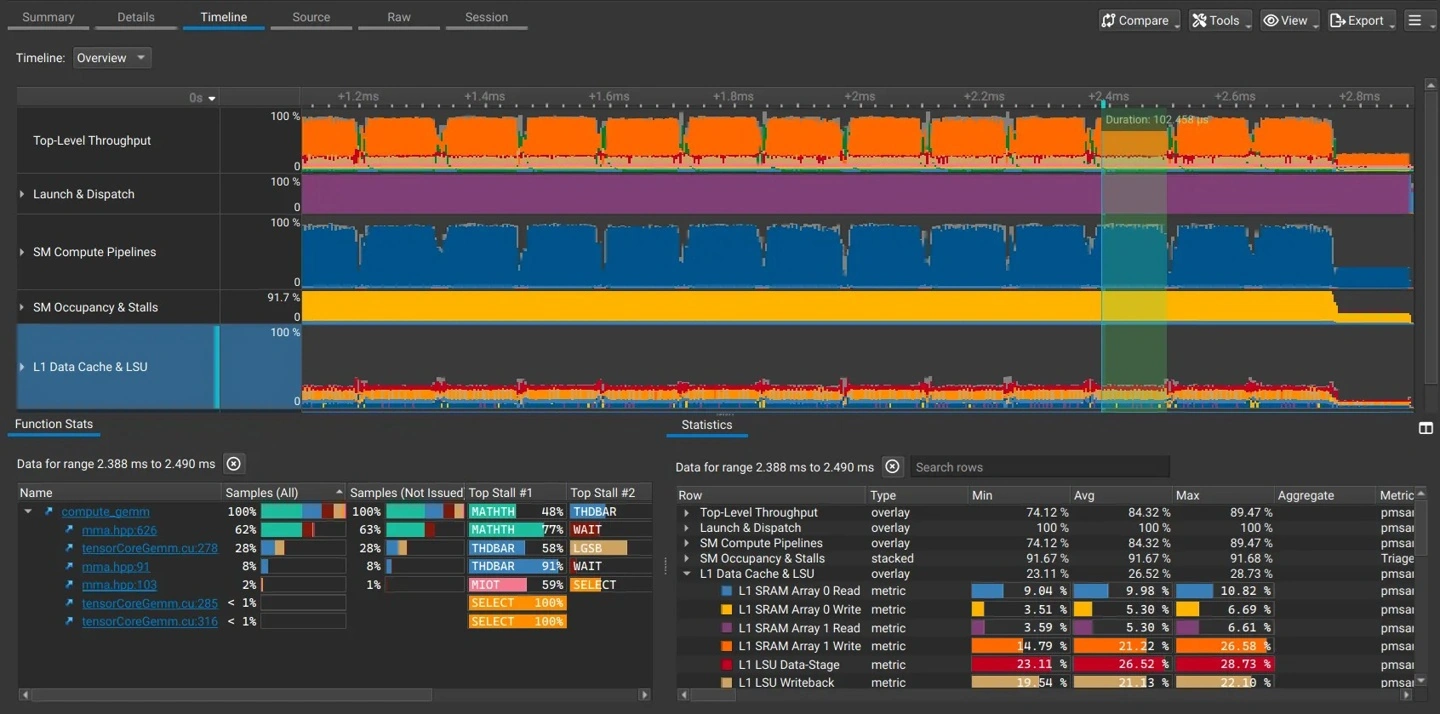
CUDA 13.5 migliora i carichi AI con ottimizzazioni per calcolo a bassa precisione
Sul fronte delle prestazioni, CUDA 13.5 aggiorna cuBLAS con nuove strategie euristiche per la moltiplicazione di matrici e con un lavoro di affinamento dei kernel pensato per l’architettura Vera Rubin. L’attenzione si concentra sui formati a bassa precisione NVFP4 e MXFP8, ormai sempre più importanti nei modelli AI avanzati e in scenari come i modelli mixture-of-experts.
L’obiettivo dichiarato è aumentare throughput in training e inferenza senza richiedere una messa a punto separata per ogni singola forma di calcolo. È un dettaglio tecnico che conta: ridurre il bisogno di autotuning specifico può semplificare il lavoro degli sviluppatori e velocizzare la messa in esercizio di carichi complessi su hardware di nuova generazione.
La nuova gestione delle GPU punta su scheduling più flessibile e comunicazione multi-GPU più diretta
Un altro blocco importante riguarda NVIDIA Multi-Process Service v3, che introduce un meccanismo di time slicing pesato. In sostanza, gli amministratori possono assegnare finestre di calcolo più lunghe ai server con carichi pesanti e regolare in modo indipendente la frequenza di passaggio tra attività diverse.
Ci sono novità anche nella suddivisione delle risorse per dominio locale, con due modalità di partizionamento degli SM: una più prevedibile e uniforme, l’altra pensata per sfruttare il più possibile tutta la capacità disponibile della GPU.
Sul versante multi-GPU, CUDA Tile ora consente di accedere direttamente alla memoria video di altre GPU dall’interno del kernel, sfruttando NVLink. Con i puntatori multicast e operazioni di memoria dedicate, diventa possibile eseguire riduzioni e scritture tra GPU anche su reti NVSwitch compatibili con NVLink SHARP.
Arrivano nuovi tool di analisi e cambia il supporto driver su Windows per Rubin
CUDA 13.5 introduce in anteprima pubblica anche NVIDIA Nsight Perf SDK for AI, pensato per il profiling continuo di sessioni di training e inferenza molto lunghe. Lo strumento raccoglie in modo persistente metriche GPU e CPU insieme al contesto di esecuzione, così da individuare più facilmente problemi prestazionali intermittenti, con visualizzazione dei risultati tramite Perfetto.
L’aggiornamento tocca inoltre CUDA Python 1.2, CUDA Graph e CCCL 3.5. Tra le aggiunte figurano copie di memoria in batch, dipendenze di avvio programmatiche, aggiornamenti più flessibili dei graph e nuove funzioni come la selezione Top-K in batch.

