
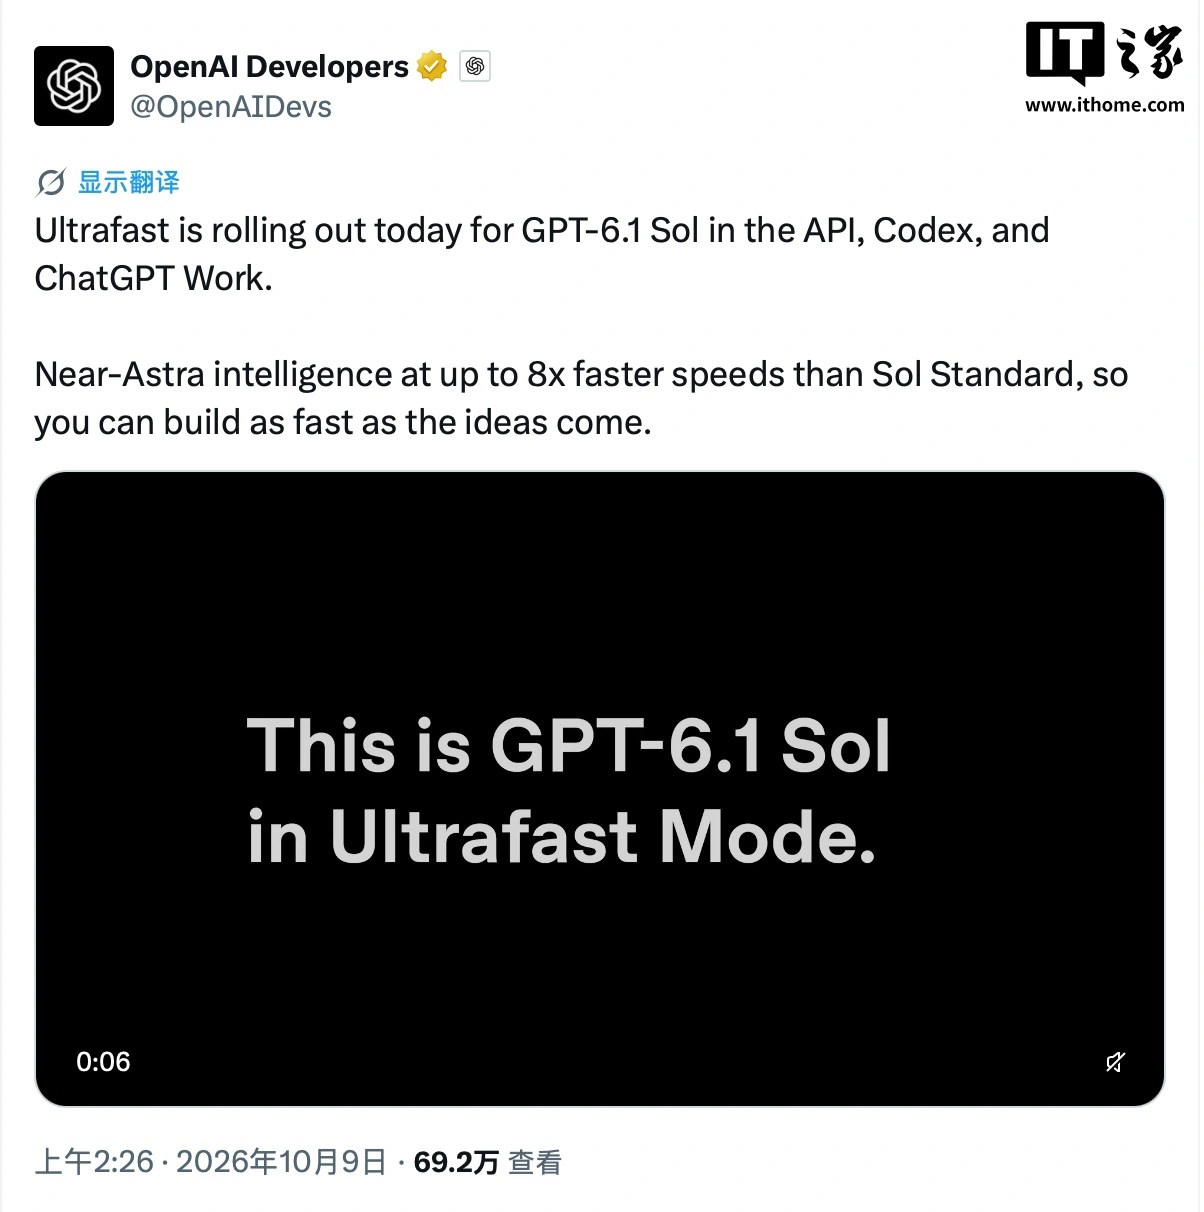

OpenAI ha lanciato la variante Ultrafast di GPT-6.1 Sol, disponibile da subito in API, Codex e ChatGPT Work. Il nuovo profilo punta chiaramente sulla velocità: l’azienda indica prestazioni fino a 8 volte superiori rispetto a Sol Standard.
Il rovescio della medaglia è il costo, che sale in modo netto. Ultrafast viene proposto a un prezzo pari a 6 volte quello della versione standard, con tariffazione fissata a 12 dollari per milione di token in input e 60 dollari per milione di token in output, ciòè circa 11 euro e 55 euro.
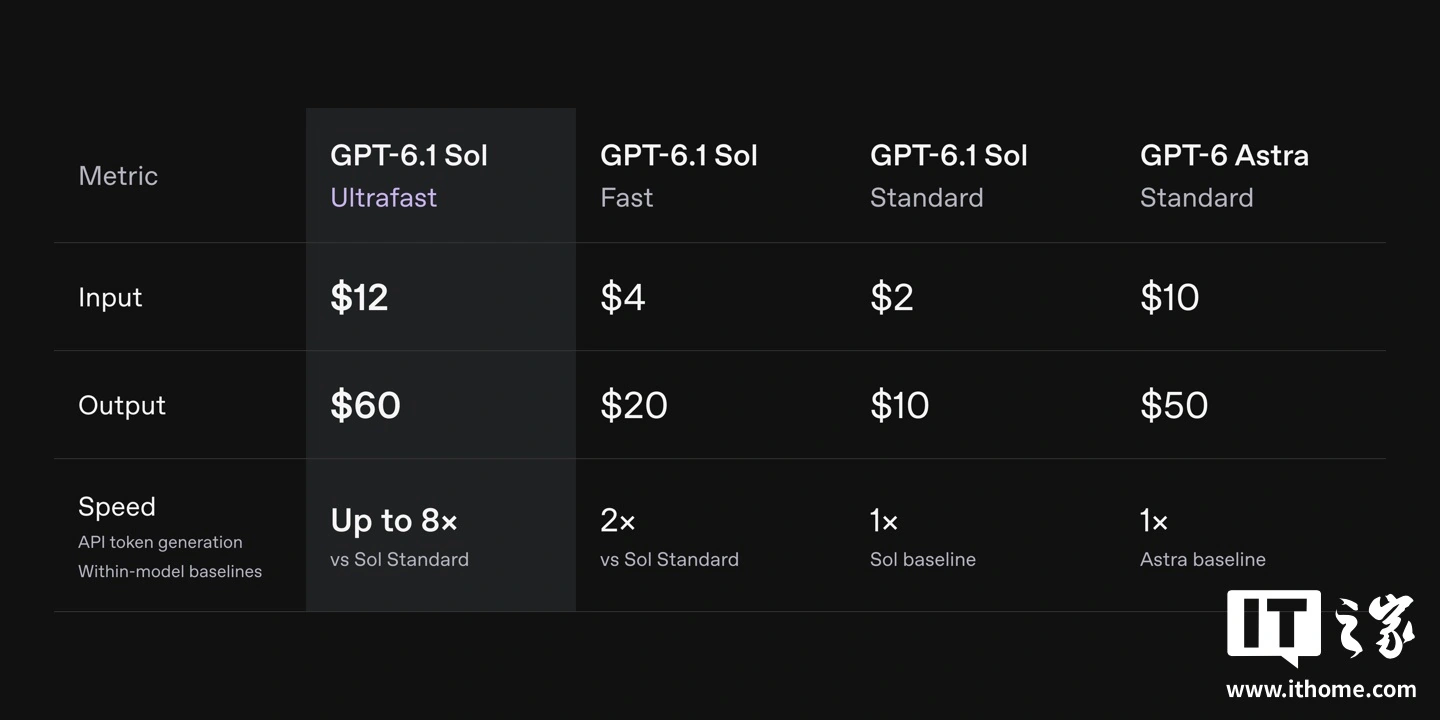
GPT-6.1 Sol Ultrafast accelera API, Codex e ChatGPT Work
La novità non riguarda un singolo prodotto, ma tre ambienti distinti dell’ecosistema OpenAI. In API può interessare chi integra modelli linguistici in applicazioni e servizi, mentre in Codex e ChatGPT Work assume un valore ancora più pratico per attività di scrittura, automazione e sviluppo dove la latenza incide direttamente sulla produttività.
Il dato più rilevante è proprio il rapporto tra prestazioni e prezzo. OpenAI presenta Ultrafast come una modalità molto più veloce della base Sol Standard, ma il salto di costo è comunque elevato.
Disponibilità già attiva con supporto per residenza dei dati in Usa e Unione europea
Sul fronte dell’accesso, la funzione è già stata abilitata in tutti i territori supportati. In Codex e ChatGPT Work è disponibile per gli abbonamenti Pro 500, per le aziende con piano enterprise a consumo idoneo e per i piani education basati su crediti. Per gli account aziendali serve però un passaggio aggiuntivo: l’amministratore deve attivare esplicitamente il permesso.
OpenAI segnala inoltre il pieno supporto ai servizi di residenza dei dati negli Stati Uniti e nell’Unione europea. È un aspetto importante perché rende questa variante più adatta anche ai contesti dove conformità e gestione territoriale dei dati sono requisiti operativi concreti, non semplici voci accessorie.
Nel complesso, GPT-6.1 Sol Ultrafast sembra una proposta molto mirata: meno interessante per chi guarda solo al costo per token, ma potenzialmente utile per chi ha bisogno di throughput elevato, tempi di attesa ridotti e integrazione immediata negli strumenti OpenAI già in uso.

