


OpenAI ha presentato il nuovo livello di servizio Ultrafast durante il Developer Day 2026, introducendo GPT-6 Astra Ultrafast come opzione pensata per chi ha bisogno di tempi di risposta molto più rapidi senza scendere a compromessi su modelli meno capaci.
La nuova modalità è già disponibile via API, mentre l’accesso in ChatGPT Work e Codex è riservato agli utenti Pro 500 e alle aziende. OpenAI ha inoltre anticipato l’arrivo di GPT-6.1 Sol Ultrafast, segnale che questo nuovo tier non è un esperimento isolato ma una direzione precisa per i carichi di lavoro più sensibili alla latenza.
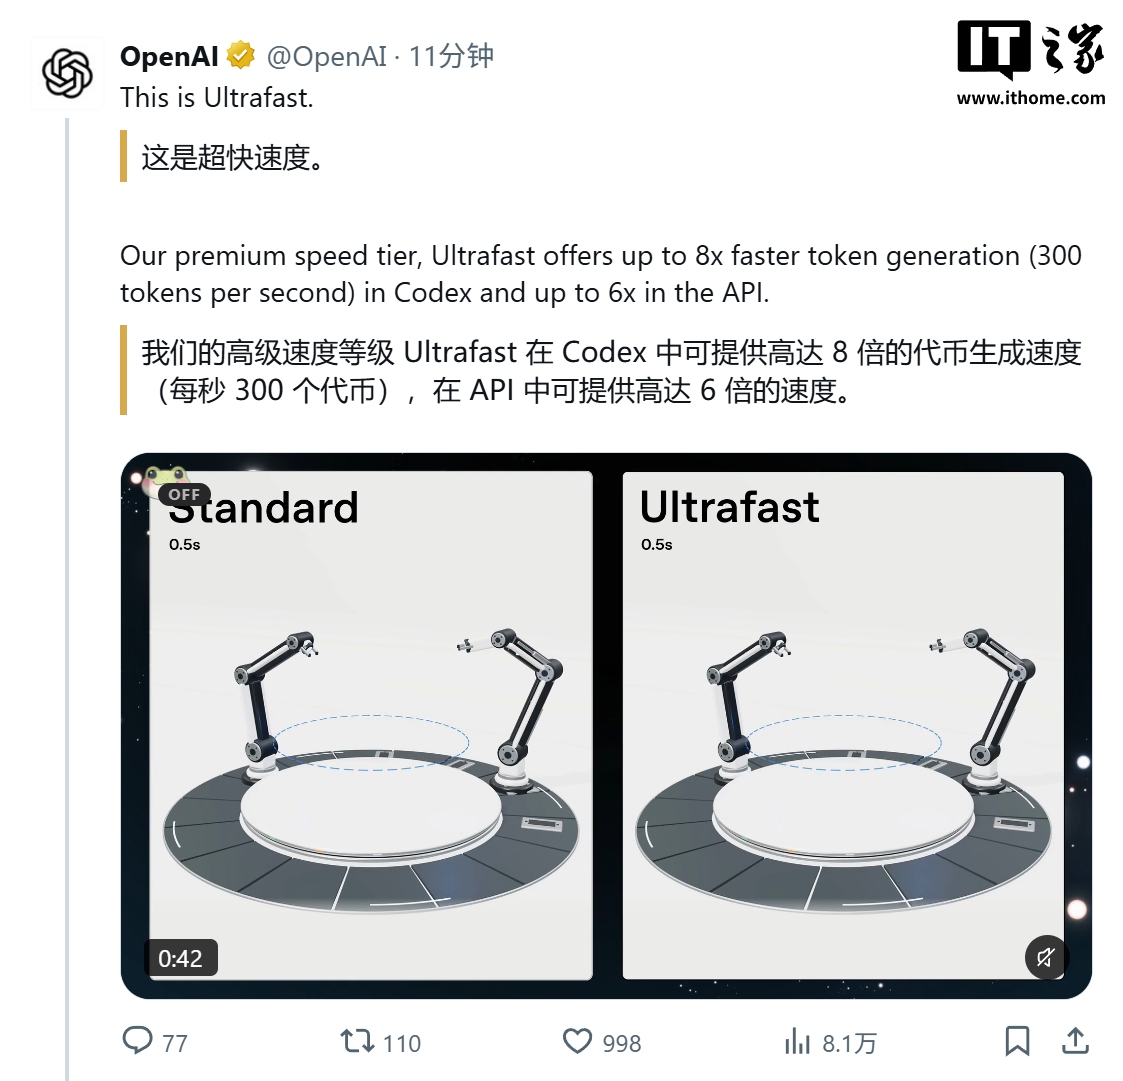
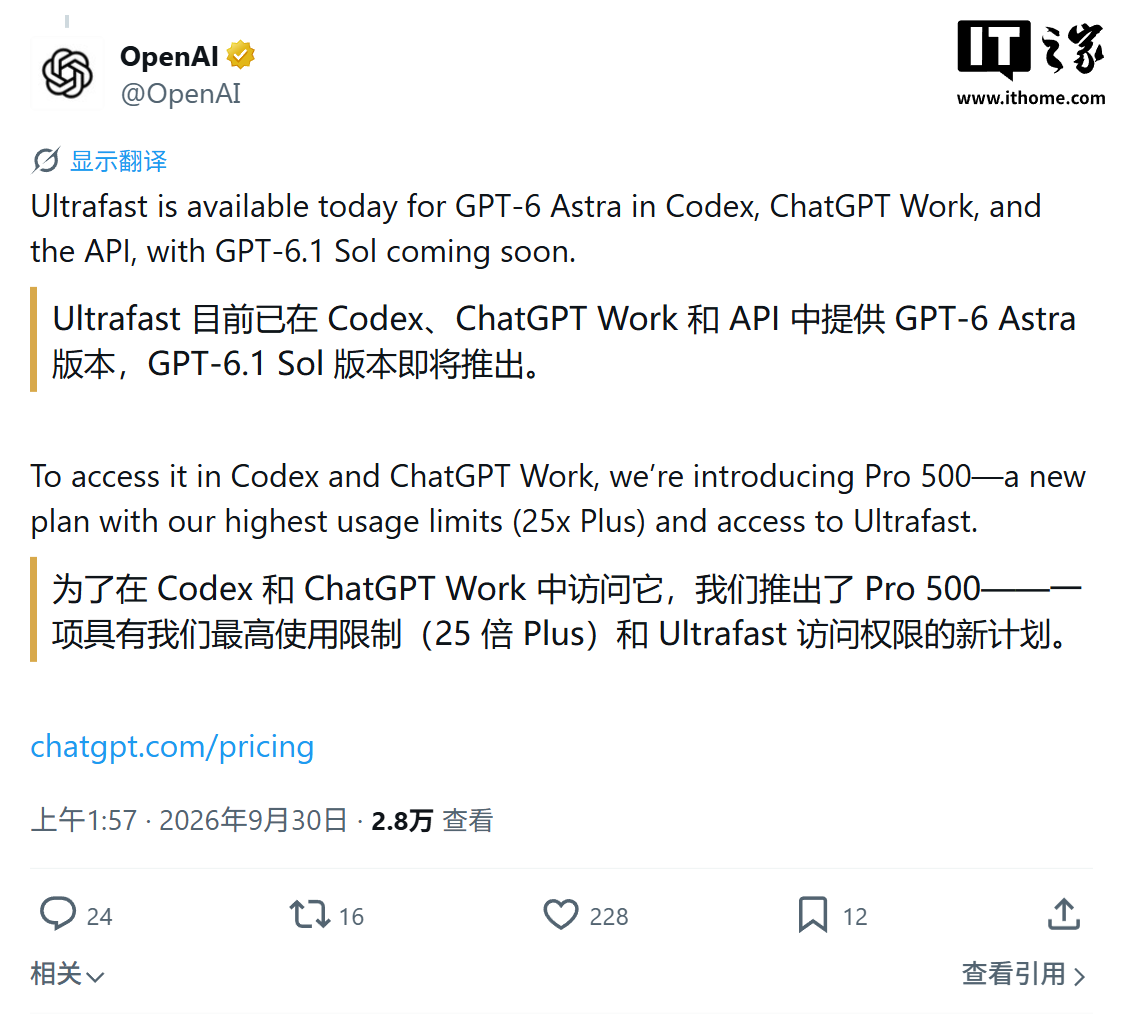
Ultrafast punta sulla velocità reale nei flussi di lavoro più pesanti
OpenAI descrive Ultrafast come un nuovo livello di servizio capace di aumentare in modo netto la produttività del modello nei contesti operativi. In Codex la generazione può essere fino a 8 volte più veloce, mentre nelle chiamate API il guadagno dichiarato arriva fino a 6 volte. L’obiettivo non è soltanto ridurre il tempo d’attesa, ma aumentare la quantità di lavoro utile completata nell’unità di tempo.
Il punto interessante è che OpenAI prova a tenere insieme due esigenze che spesso si escludono a vicenda: usare un modello più forte e ottenere risposte vicine al tempo reale. Finora, per avere latenze molto basse, era spesso necessario passare a modelli più piccoli o più specializzati.
GPT-6 Astra Ultrafast è già attivo via API e inizia a entrare nell’ecosistema OpenAI
La disponibilità parte subito dall’API, quindi il target iniziale è chiaramente quello degli sviluppatori e delle aziende che vogliono integrare il modello in strumenti proprietari, pipeline automatiche o assistenti software.
Nel quadro tecnico rientra anche la logica della cache dei prompt: la prima scrittura di un input nella cache prevede un costo dedicato, mentre le richieste successive che riutilizzano lo stesso contenuto vengono tariffate a un livello più basso.
Dall’assistenza in tempo reale al coding interattivo, Ultrafast guarda ai casi d’uso più sensibili alla latenza
OpenAI posiziona questo tier per scenari come risposta agli eventi, customer care in tempo reale, generazione di aggiornamenti rapidi su mercati e trading, oltre alla programmazione interattiva. In tutti questi casi il valore non dipende soltanto dalla qualità dell’output finale, ma dalla capacità del modello di reagire quasi istantaneamente mentre l’utente continua a lavorare.
La novità si inserisce in una fase in cui OpenAI sta spingendo anche sull’infrastruttura per agenti, con l’apertura in beta pubblica dell’Agents API e il supporto a esecuzione di codice, uso di strumenti e attività su più contesti.

