


Meta ha annunciato Muse Glimmer, un nuovo modello aperto da 30 miliardi di parametri pensato per flussi di lavoro agentici in locale. Il punto centrale della novità è chiaro: offrire un modello abbastanza compatto da girare su Mac o PC con una singola GPU consumer, mantenendo però capacità utili per coding, uso di strumenti.
I pesi vengono rilasciati con licenza Apache 2.0, quindi con un’impostazione molto permissiva anche per sviluppo e integrazione. Muse Glimmer è già disponibile su Hugging Face, con documentazione dedicata per chi vuole costruire agenti locali sempre attivi, senza dipendere in modo continuo dal cloud o dalla connessione di rete.
Muse Glimmer punta sugli agenti locali e sull’hardware consumer
L’idea dietro Muse Glimmer è rendere più praticabile l’uso di agenti AI direttamente sul dispositivo. Meta lo presenta come un modello progettato per attività continuative, con accesso al contesto personale, gestione di richieste su più passaggi e capacità di richiamare strumenti in modo preciso.
Per arrivarci, Meta ha bilanciato capacità e vincoli di memoria con una combinazione di architettura compatta, distillazione da un modello insegnante più grande e ottimizzazioni in inferenza. Il modello è stato sviluppato in più fasi, dal pre-training alla rifinitura finale, includendo distillazione, fine-tuning supervisionato e rinforzo su domini come ragionamento, codice e task agentici.
Capacità agentiche, multimodalità e benchmark sono i punti da osservare
Sul piano funzionale, Muse Glimmer è stato addestrato ed evaluato per completare task end-to-end, usare tool tramite schemi di chiamata, mantenere ragionamenti su più passaggi e recuperare dagli errori quando una funzione fallisce o restituisce un risultato inatteso.
Meta evidenzia anche il supporto agli input multimodali grazie a un encoder dedicato alla percezione, con la possibilità di elaborare testo e immagini insieme. Significa che il modello può interpretare schermate, grafici e documenti all’interno dello stesso flusso di lavoro.
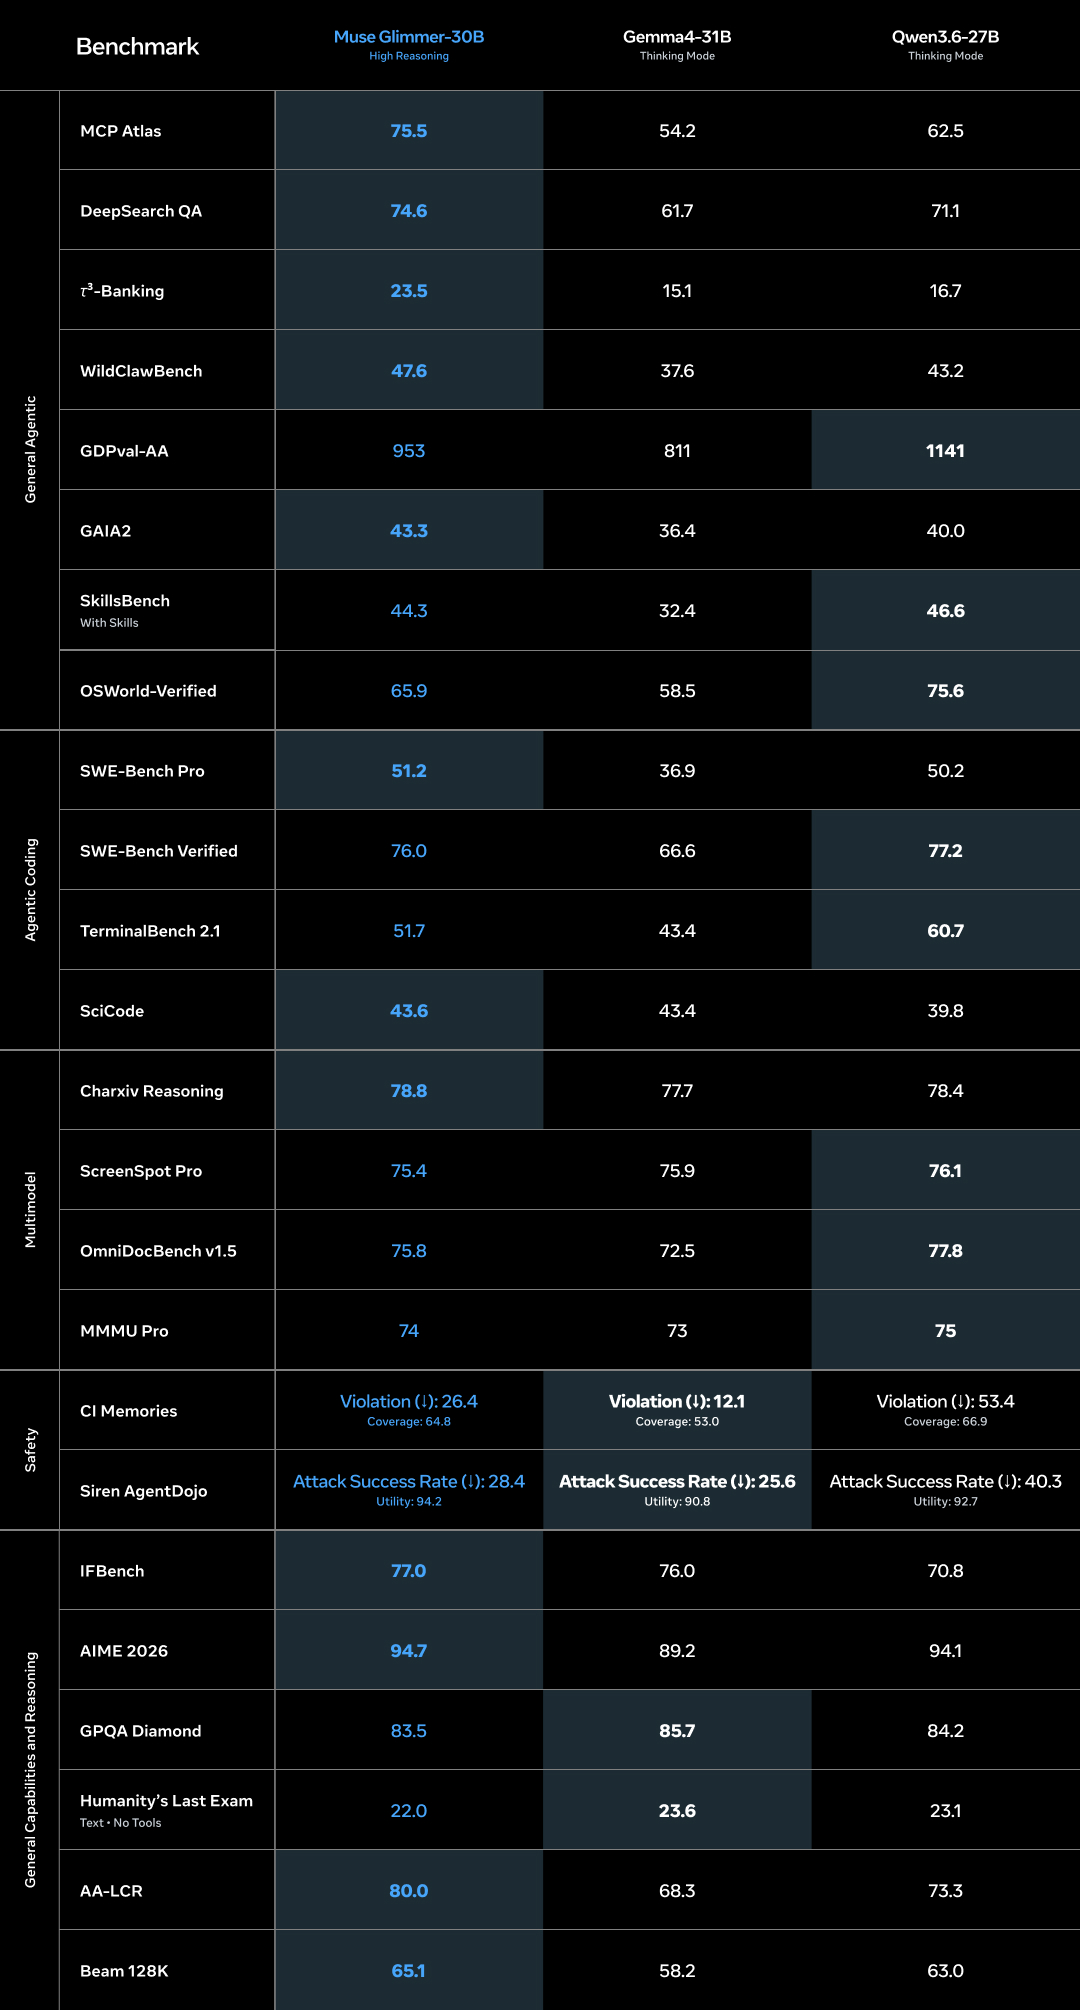
Nei benchmark citati, Muse Glimmer viene posizionato in modo competitivo rispetto ad altri modelli della stessa fascia dimensionale, come Gemma4-31B e Qwen3.6-27B. Il messaggio qui non è tanto quello di superare i modelli più grandi in assoluto, quanto di offrire un rapporto interessante tra dimensioni, prestazioni e possibilità di esecuzione in locale.
Quantizzazione e decoding speculativo rendono il modello più pratico da usare
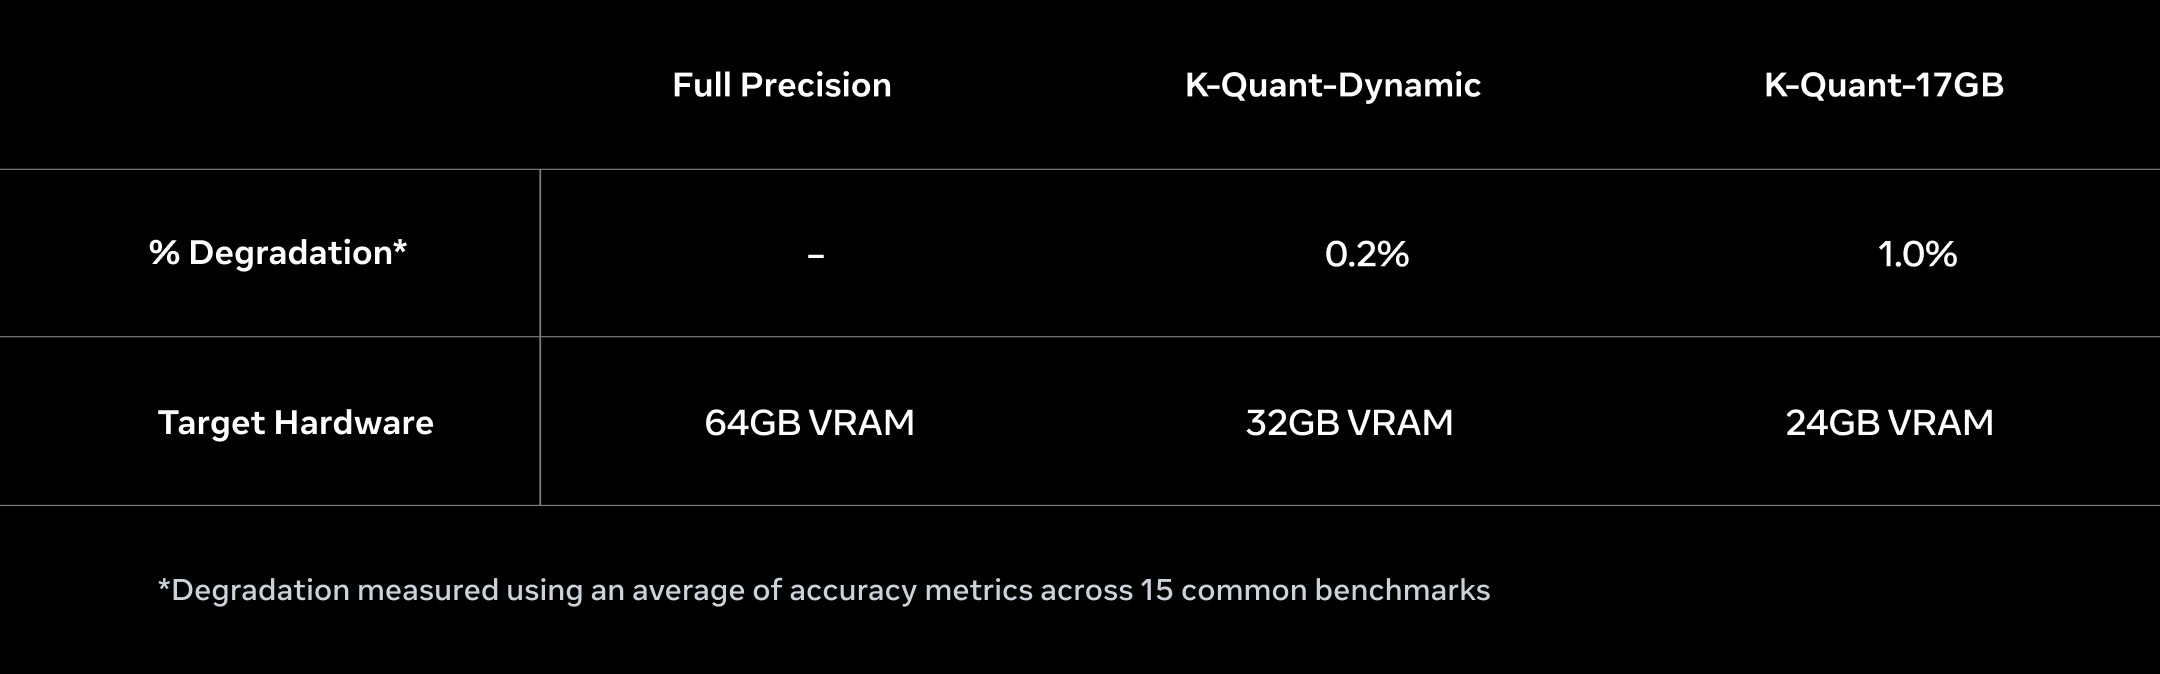
L’aspetto più concreto riguarda i requisiti. A piena precisione, un modello di queste dimensioni supererebbe i 55 GB di memoria, quindi fuori portata per gran parte dell’hardware consumer. Meta adotta invece tecniche di quantizzazione fino a circa 4 bit, riducendo il modello linguistico a meno di 20 GB.
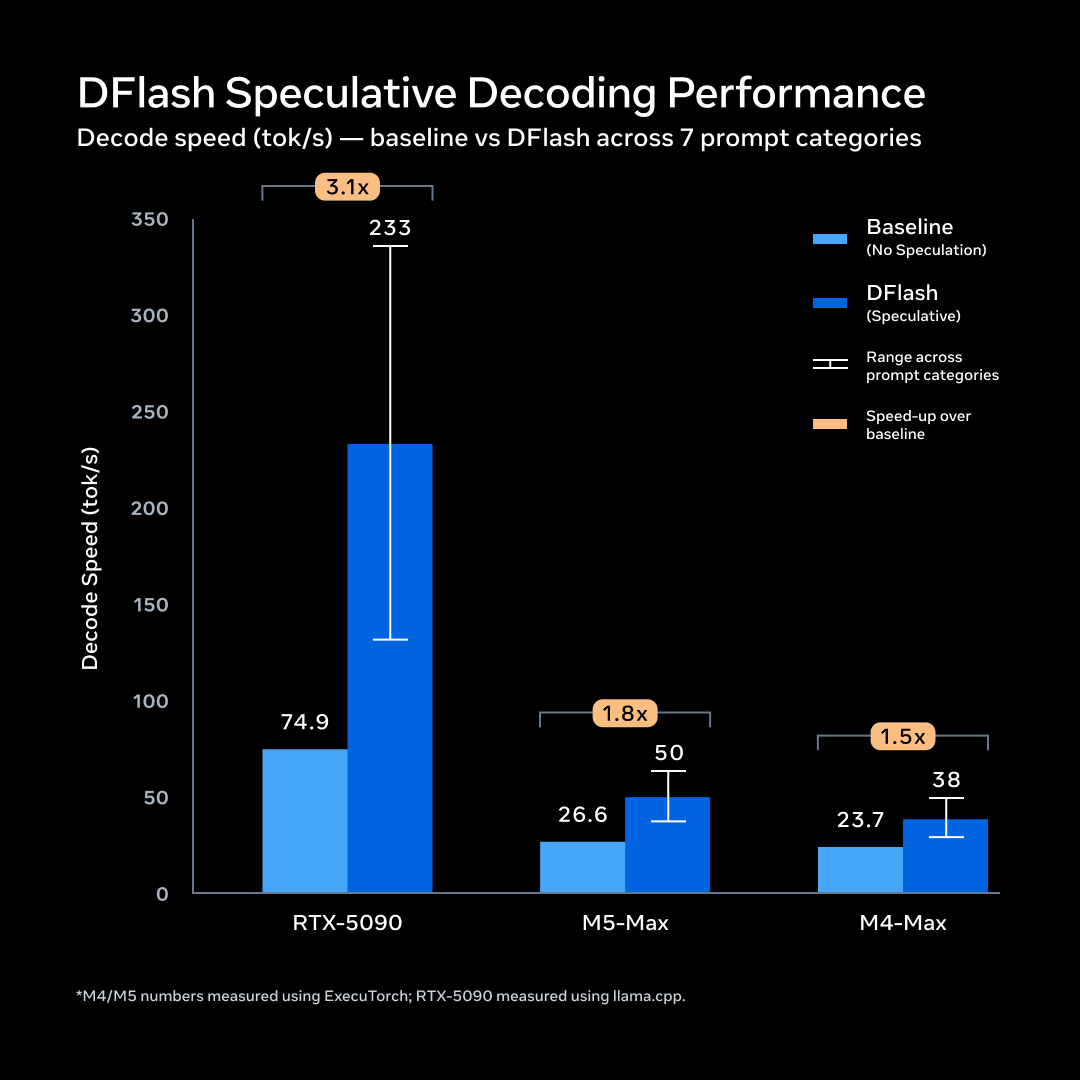
Per migliorare la reattività, Muse Glimmer usa anche il decoding speculativo con un piccolo modello ausiliario basato su DFlash, che propone blocchi di token mentre il modello principale li verifica in parallelo. L’obiettivo è aumentare la velocità di generazione senza peggiorare la qualità dell’output.
Sul fronte disponibilità, il rilascio è già partito su Hugging Face. Nei prossimi giorni sono previsti anche integrazioni e supporto ottimizzato con strumenti come llama. cpp, MLX, ExecuTorch, oltre a piattaforme note come Ollama, LM Studio e Unsloth. Per gli sviluppatori interessati a modelli aperti ma più orientati all’uso pratico che alla sola sperimentazione, Muse Glimmer è una proposta da seguire con attenzione.


