
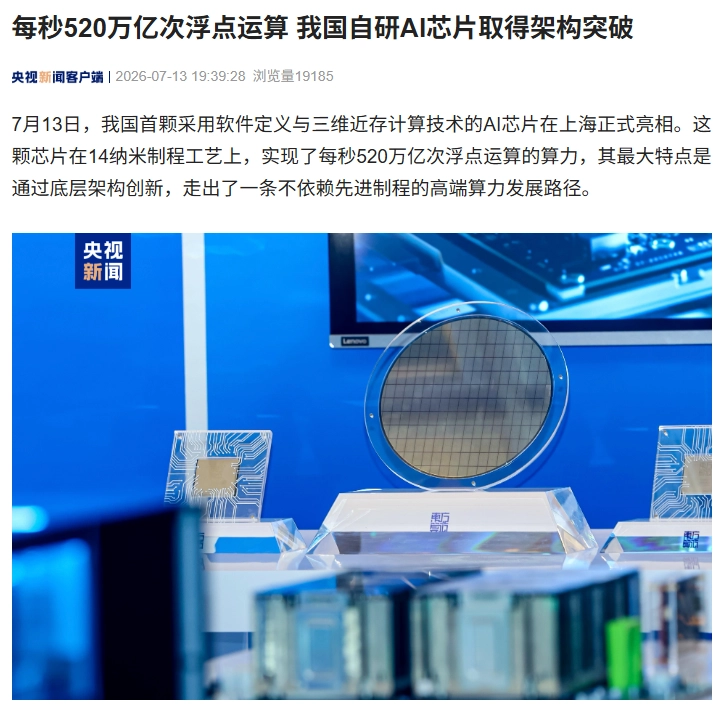

In Cina è stata presentata la prima chip AI nazionale che unisce software-defined chip e calcolo tridimensionale near-memory, una soluzione pensata per superare il limite della memoria senza puntare solo sul nodo produttivo.
L’interesse non è solo nel numero secco di calcolo, ma nell’impianto complessivo: la piattaforma nasce con una catena software completa e con un ecosistema che va dalla singola scheda acceleratrice fino ai grandi cluster di calcolo IA, un elemento che pesa molto quando si parla di uso reale e non solo di picchi teorici.
Una chip AI da 520 trilioni di operazioni punta sull’architettura, non solo sul processo
La chip è stata mostrata a Shanghai e rappresenta la prima soluzione nazionale a usare insieme software-defined chip e calcolo tridimensionale near-memory. In pratica, l’idea è rendere l’hardware più flessibile via software e avvicinare molto di più unità di calcolo e memoria, così da ridurre i colli di bottiglia nei carichi tipici dell’intelligenza artificiale.
Il punto chiave è che la prestazione dichiarata, 520 trilioni di operazioni in virgola mobile al secondo, arriva su un processo produttivo a 14 nanometri. Questo indica una strada alternativa rispetto alla sola corsa alla miniaturizzazione, con l’obiettivo di mantenere alte prestazioni anche senza dipendere dalle tecnologie più avanzate di fonderia.
- Potenza dichiarata: 520 trilioni di operazioni in virgola mobile al secondo
- Processo produttivo: 14 nanometri
- Tecnologie chiave: software-defined chip e calcolo tridimensionale near-memory
- Obiettivo tecnico: ridurre il problema del “muro della memoria”
Non solo chip: arriva una piattaforma completa per server, acceleratori e cluster IA
Insieme alla chip è stata presentata anche una catena software completa, compatibile con i principali framework di deep learning. Questo è un passaggio importante, perché nell’hardware IA la maturità del software conta quasi quanto la potenza nominale: senza driver, compilatori, runtime e strumenti di analisi, una chip resta difficile da adottare su larga scala.
La proposta include inoltre un’intera famiglia di prodotti: scheda acceleratrice singola, server IA, nodi super densi raffreddati a liquido e grandi cluster di calcolo intelligente. L’obiettivo dichiarato è offrire una base pronta per addestramento e inferenza di modelli di grandi dimensioni, con un percorso che va dal singolo sistema fino all’infrastruttura distribuita.
- Catena software compatibile con i principali framework di deep learning
- Offerta che copre dalla singola acceleratrice ai grandi cluster
- Presenza di server IA e nodi super densi con raffreddamento a liquido
- Pensata per addestramento e inferenza di modelli di grandi dimensioni
La strategia punta a un calcolo più autonomo e meno legato alle fonderie più avanzate
Il messaggio industriale è chiaro: questa linea tecnologica prova a costruire una base di calcolo più stabile e controllabile, senza dipendere in modo esclusivo dalla corsa ai nodi più spinti. Per un settore come quello dell’IA, dove domanda di potenza e disponibilità della supply chain pesano entrambe, è un cambio di prospettiva significativo.
Il confronto implicito è con le soluzioni che puntano soprattutto su banda memoria e prestazioni di piattaforma. Qui l’enfasi è invece sull’integrazione architetturale, con un approccio che mira a migliorare efficienza e scalabilità. È un segnale da seguire perché può influenzare sia il design delle prossime chip sia l’organizzazione delle infrastrutture IA su larga scala.
- La strategia riduce la dipendenza dai nodi produttivi più avanzati
- Punta su una supply chain più stabile e controllabile
- Mira a migliorare efficienza, scalabilità e utilizzo reale del calcolo
- È pensata come base per infrastrutture IA di grande dimensione

