Princeton University ha pubblicato CEO-Bench, un benchmark che mette alla prova i modelli AI nel ruolo di amministratore delegato di una startup simulata. Il risultato piu netto e che la maggior parte dei sistemi testati non riesce a gestire un orizzonte lungo e finisce per bruciare il capitale iniziale.
La simulazione copre 500 giorni di attivita con una cassa di partenza da 1 milione di dollari e chiede al modello di prendere decisioni continue su prezzo, budget, analisi competitiva e strategia. Tra i partecipanti, Claude Fable 5 emerge come il profilo piu solido, mentre diversi nomi noti chiudono in bancarotta.
CEO-Bench simula la guida completa di una startup per 500 giorni
CEO-Bench e pensato per valutare le capacita gestionali degli agenti AI in contesti aziendali di lungo periodo, con molte variabili in movimento e informazioni incomplete. L’obiettivo non e misurare una singola risposta, ma la tenuta strategica nel tempo davanti a un ambiente rumoroso e incerto.
Ogni agente opera su base settimanale e puo usare senza limiti 34 strumenti dedicati a pricing, crescita, prodotto, operations, raccolta informazioni, comunicazione pubblica e vendite enterprise. A disposizione ci sono anche 19 database SQL aziendali da interrogare per orientare le decisioni.
- Capitale iniziale della simulazione: 1 milione di dollari.
- Durata della prova: 500 giorni di attivita aziendale continuativa.
- Scenario con 26 segmenti clienti diversi, con sensibilita al prezzo e preferenze qualitative non visibili direttamente al modello.
- Gli agenti devono inferire l’andamento del business da abbonamenti, churn, ticket di supporto, ricavi, reputazione e feedback social.
- La qualita del prodotto dipende da molte leve insieme: sviluppo quotidiano, ricerca, livello del modello, sviluppo mirato, capacita infrastrutturale, supporto clienti
Claude Fable 5 e l’unico modello davvero consistente, mentre molti rivali falliscono
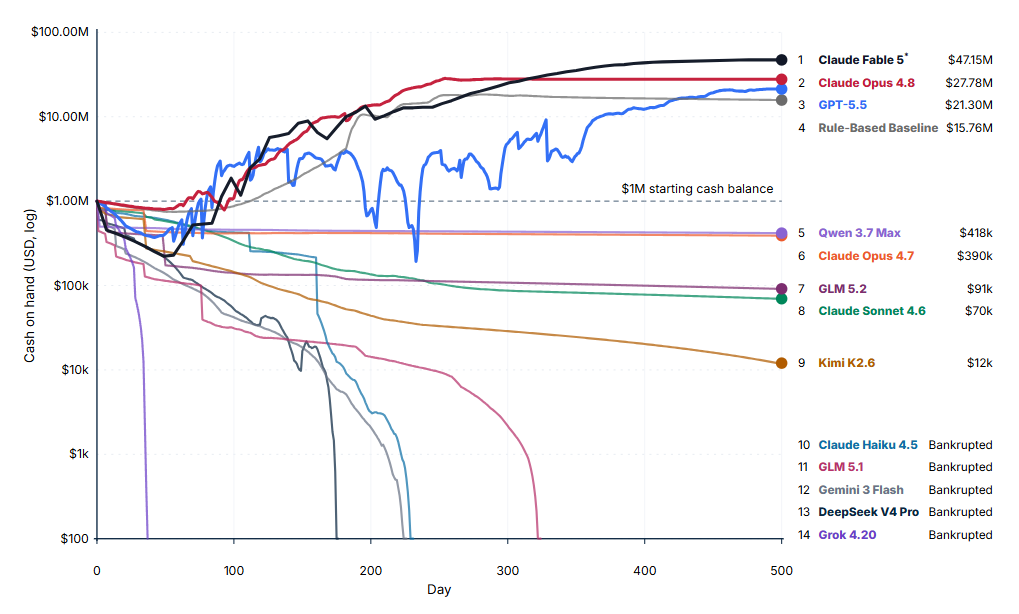
La fotografia finale e severa: molti modelli attuali non riescono neppure a preservare il capitale iniziale dopo 500 giorni. La miglior singola esecuzione appartiene a Claude Fable 5, che chiude con 47,15 milioni di dollari di cassa finale, un margine molto distante dal resto del gruppo.
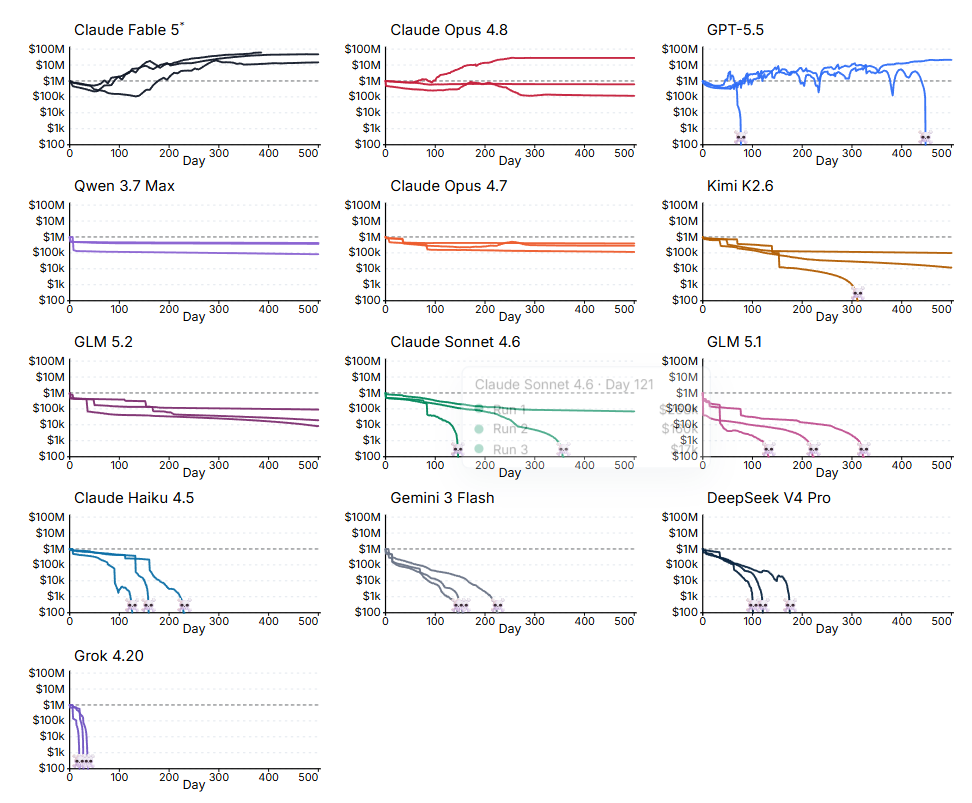
Nei tre test eseguiti, modelli come Grok 4.20, DeepSeek V4 Pro e Gemini 3 Flash terminano sempre in bancarotta. Grok 4.20 risulta il peggiore del lotto, con una sopravvivenza media di appena 28 giorni.
- Claude Fable 5 e l’unico modello con risultati sopra il capitale iniziale in piu esecuzioni.
- Miglior singola run di Claude Fable 5: 47,15 milioni di dollari finali.
- Claude Opus 4.8 e GPT-5.5 superano il milione iniziale solo nella loro miglior esecuzione.
- Qwen 3.7 Max, Claude Opus 4.7, Kimi K2.6, GLM 5.2 e Claude Sonnet 4.6 chiudono con cassa positiva, ma inferiore al capitale iniziale.
- Grok 4.20, DeepSeek V4 Pro e Gemini 3 Flash falliscono in tutte e tre le prove.
- Il modello basato su regole usato come riferimento termina con 15,8 milioni di dollari.