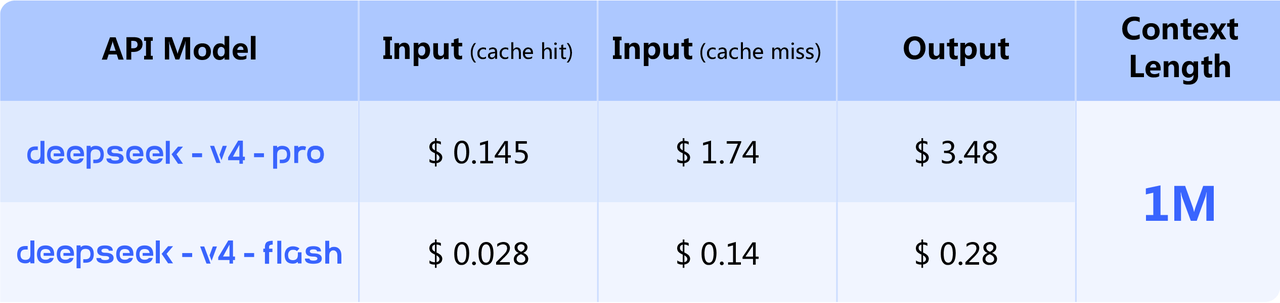
DeepSeek ha presentato una preview del suo nuovo modello DeepSeek-V4, disponibile con accesso ai pesi aperti e tramite API. La novità arriva in due versioni, Expert e Instant, con capacità pensate per ragionamento, coding e uso con agenti.
Il dato più interessante è la struttura del modello: DeepSeek-V4 è distribuito come open-weights, quindi può essere scaricato e, in teoria, eseguito su hardware proprio. In pratica servono risorse importanti, ma il progetto apre la strada anche a versioni quantizzate e ottimizzate dalla comunità.
DeepSeek-V4 debutta in preview con due modalità d’uso
La preview di DeepSeek-V4 è già disponibile per chi possiede un account DeepSeek, con accesso tramite la piattaforma chat del servizio. Le due modalità sono Expert, pensata per i compiti più pesanti, e Instant, orientata a risposte più rapide.
DeepSeek definisce Expert come il modello più potente della serie, mentre Instant punta a un compromesso più pratico tra velocità e capacità. In entrambi i casi, la novità è l’apertura del modello ai pesi scaricabili, un aspetto che lo distingue da molti concorrenti chiusi.
- Due versioni disponibili: Expert e Instant.
- Accesso anche in forma di open-weights, con pesi scaricabili da Hugging Face.
- Uso possibile anche tramite API per chi non vuole eseguire il modello in locale.
Numeri molto alti: 1,6 trilioni di parametri per Expert
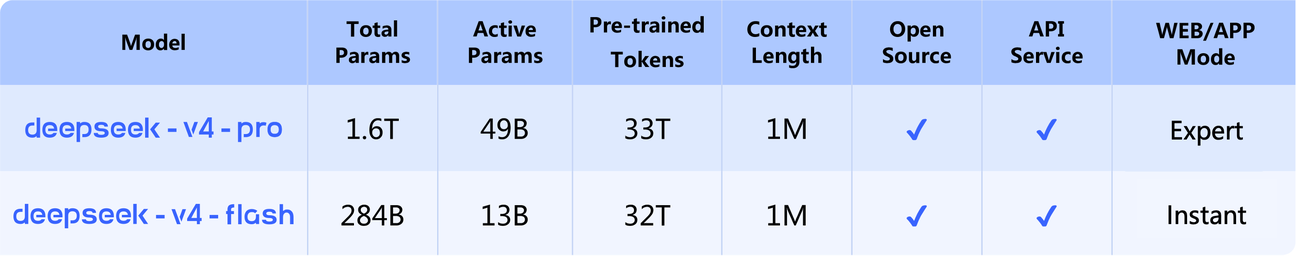
DeepSeek ha pubblicato due configurazioni principali. Expert arriva a 1,6 trilioni di parametri, mentre Instant si ferma a 284 miliardi di parametri. Sono cifre enormi, ma solo una parte dei parametri viene attivata davvero durante l’inferenza.
Nel dettaglio, il modello Expert, indicato anche come V4-Pro, usa 49 miliardi di parametri attivi. Instant, associato a V4-Flash, ne usa 13 miliardi attivi. Questo incide sui requisiti di memoria video, anche se il modello resta impegnativo da gestire in locale.
La finestra di contesto per entrambe le versioni arriva a 1 milione di token, un valore molto alto e utile per documenti lunghi, codice e carichi di lavoro complessi.
- Expert: 1,6 trilioni di parametri totali, 49 miliardi attivi.
- Instant: 284 miliardi di parametri totali, 13 miliardi attivi.
- Finestra di contesto da 1 milione di token per entrambe le versioni.
DeepSeek punta su ragionamento, coding e uso con agenti
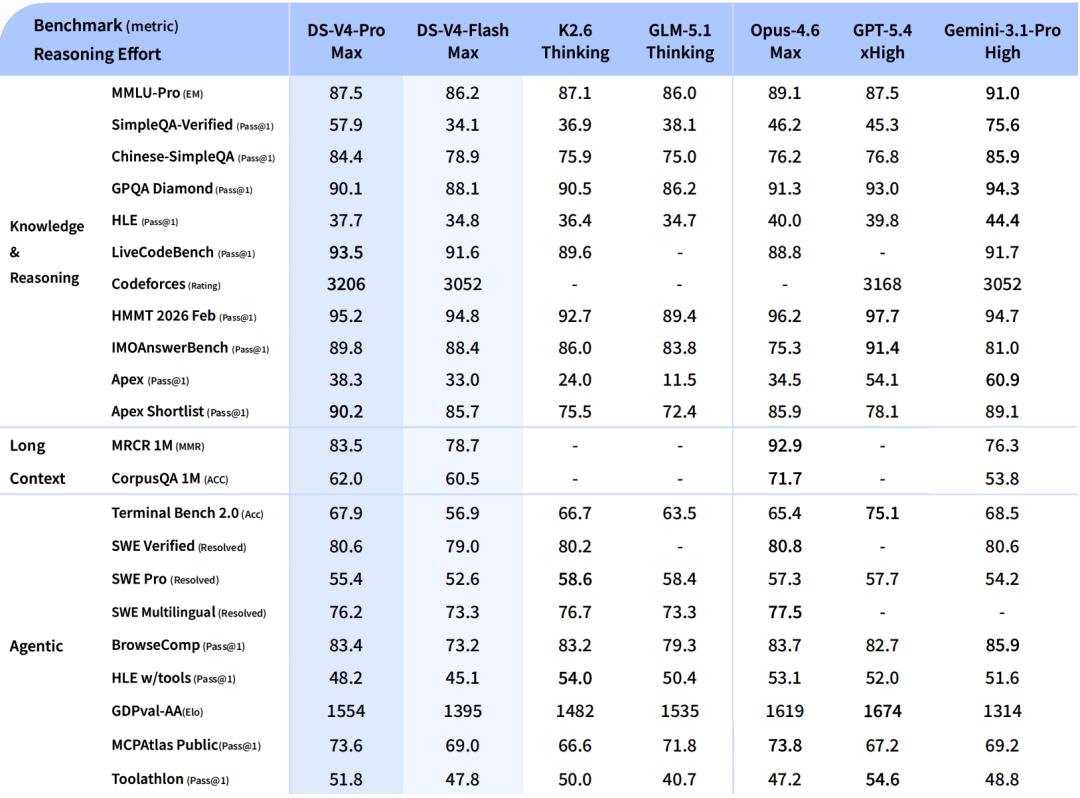
DeepSeek sostiene che V4-Flash, il motore dietro la modalità Instant, si avvicini molto a V4-Pro nelle capacità di ragionamento e si comporti bene anche nelle attività di tipo agentico più semplici. È il profilo più interessante per chi cerca un modello rapido ma ancora abbastanza solido.
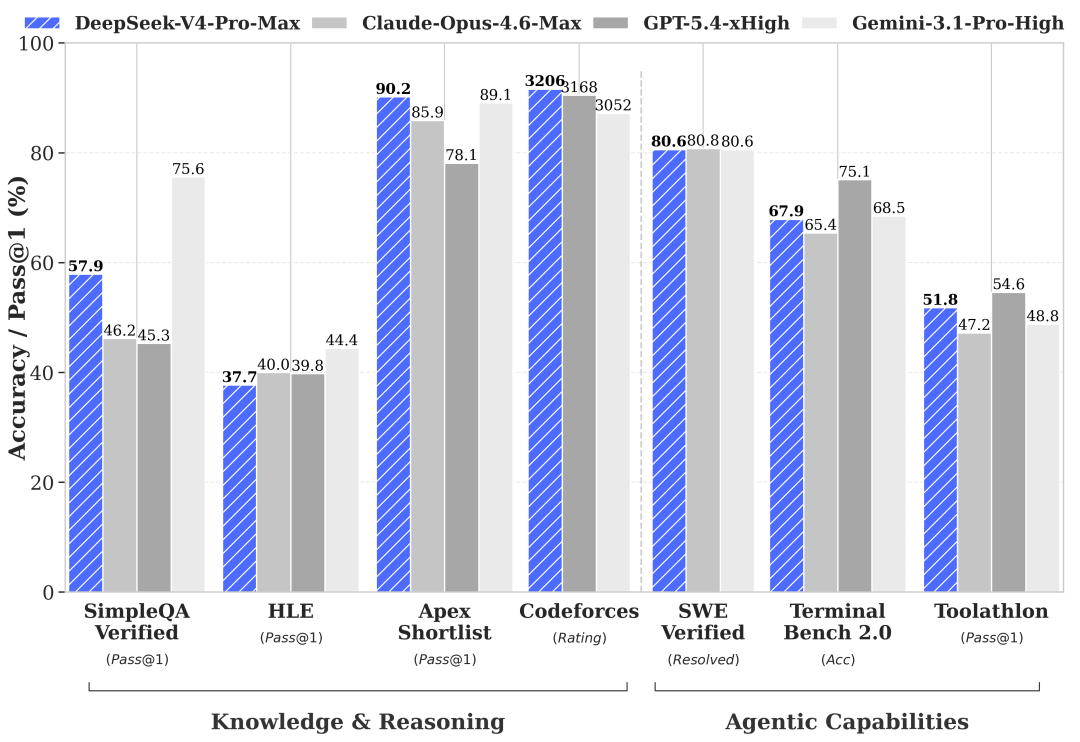
La versione V4-Pro viene presentata come la migliore tra i modelli open-weights per ragionamento matematico, discipline STEM e coding. L’azienda la colloca anche molto in alto nella conoscenza generale, con una sola eccezione dichiarata rispetto a Gemini 3.1 Pro di Google.
DeepSeek-V4 è già compatibile con strumenti diffusi come Claude Code, OpenClaw e OpenCode, un dettaglio utile per chi vuole integrarlo in flussi di lavoro già esistenti.
- V4-Flash punta a un buon equilibrio tra velocità e ragionamento.
- V4-Pro è orientato a matematica, STEM e programmazione.
- Compatibilità con strumenti di sviluppo e automazione già usati in ambito AI.